
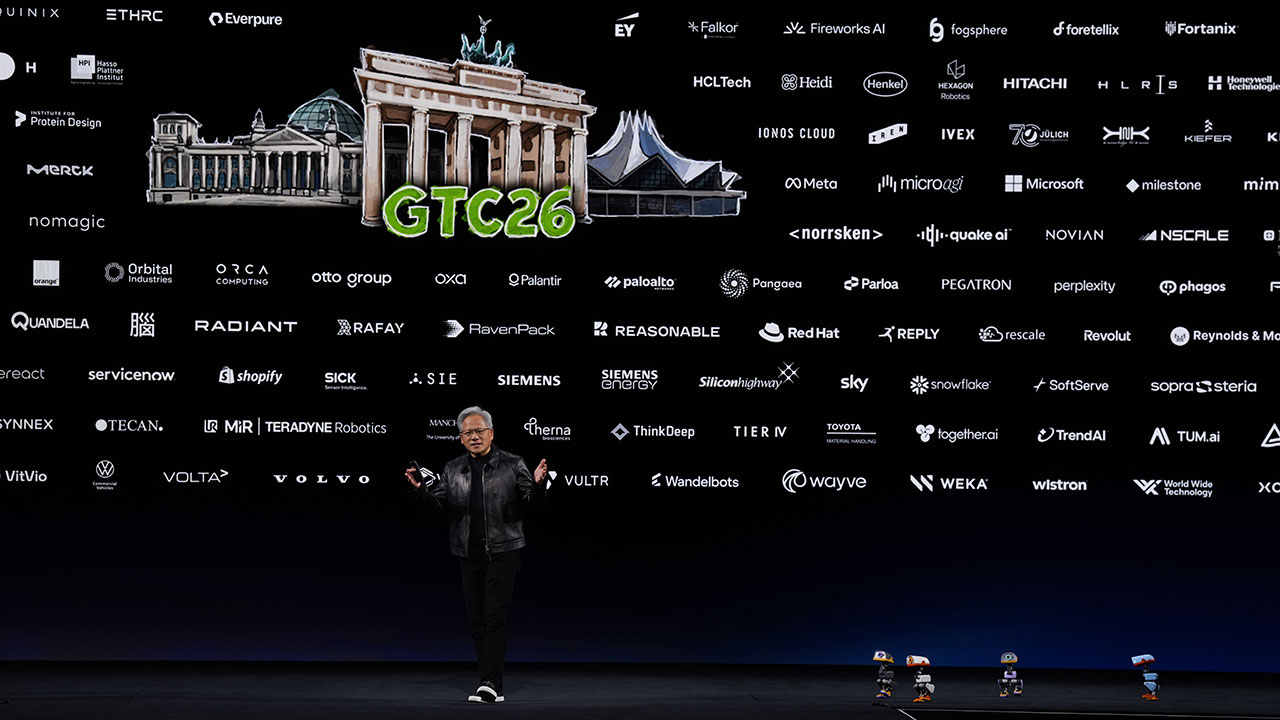

NVIDIA ha presentado durante el GTC de Berlín una estrategia europea que abarca prácticamente toda la cadena de la inteligencia artificial, desde los modelos que utilizan las empresas hasta la infraestructura necesaria para ejecutarlos. La compañía ha ampliado su catálogo de modelos abiertos, ha presentado nuevas tecnologías para reducir el consumo eléctrico y de agua de sus «fábricas de IA» y ha diseñado una arquitectura modular con la que pretende acortar de meses a semanas el despliegue de nueva capacidad de computación.
Los anuncios encajan en el mensaje que NVIDIA ha situado en el centro de su primera gran conferencia GTC europea de 2026: permitir que empresas y países desarrollen y operen más inteligencia artificial sobre sus propios datos e infraestructuras. Durante el encuentro, celebrado en Berlín los días 21 y 22 de octubre, la compañía articuló su propuesta alrededor de la denominada IA soberana y de la construcción de capacidad de computación dentro de Europa.
La estrategia amplía además el terreno en el que compite NVIDIA. Los procesadores siguen siendo la base económica de su negocio, pero el grupo está construyendo alrededor de ellos una capa cada vez más extensa de modelos, software de inferencia, herramientas de operación, arquitecturas de centros de datos y sistemas de refrigeración y energía.
Modelos abiertos para llevar la IA a datos propios
Una de las principales novedades de NVIDIA GTC Berlín es la ampliación de su catálogo de modelos abiertos. La compañía ha presentado nuevas versiones de Nemotron para lenguaje, visión y agentes, modelos para recuperación de información y una nueva familia denominada Kumo destinada a trabajar directamente con datos empresariales estructurados.
Nemotron 3.5 Super VL y los modelos Nemotron 3.5 Bolt están orientados a aplicaciones capaces de trabajar con texto e imágenes y ejecutar tareas mediante agentes. A ellos se suman Nemotron Retriever, diseñados para procesos como generación de embeddings, clasificación de resultados y análisis de documentos.
Kumo aborda un problema diferente. Su objetivo es aplicar modelos fundacionales a información tabular y relacional, habitual en sistemas corporativos, para tareas como previsión de demanda, detección de anomalías, estimación de riesgo o recomendación de acciones. NVIDIA plantea que las empresas puedan partir de modelos previamente entrenados y adaptarlos posteriormente con sus propios datos, en lugar de crear una cadena de aprendizaje automático específica para cada caso.
El catálogo se extiende a ámbitos más especializados. Cosmos 3.5 está dirigido a la simulación y entrenamiento de robots y sistemas que interactúan con el mundo físico; Alpamayo 2 Edge lleva razonamiento y planificación a vehículos autónomos; BioNeMo RFD4-Proteina se centra en el diseño de proteínas, e Ising proporciona modelos para tareas asociadas a sistemas de computación cuántica.
La amplitud de la oferta ayuda a entender qué significa «soberanía» en el planteamiento comercial de NVIDIA. Las organizaciones pueden modificar los modelos con información propia y ejecutarlos en infraestructuras bajo su control, una opción especialmente relevante para administraciones y empresas sujetas a requisitos de residencia, seguridad o gobernanza del dato.
Ese mayor control no elimina, sin embargo, la dependencia tecnológica. Los modelos abiertos forman parte de un ecosistema que NVIDIA conecta con sus GPU, sus microservicios NIM, CUDA y el resto de su pila de software e infraestructura. La compañía intenta así ocupar más capas del sistema sin exigir necesariamente que el modelo utilizado sea propietario.
DSX convierte energía, refrigeración y cómputo en un mismo sistema
La segunda parte de la estrategia está bajo el centro de datos. NVIDIA ha ampliado DSX, su arquitectura de referencia para «fábricas de IA», con tecnologías destinadas a gestionar conjuntamente servidores, redes, almacenamiento, refrigeración y suministro eléctrico.
Uno de los principales problemas que intenta resolver es la disponibilidad de energía. DSX MaxLPS distribuye dinámicamente la potencia disponible entre los sistemas de cómputo y, de acuerdo con NVIDIA, puede generar el mismo número de tokens utilizando hasta un 30% menos de potencia. El resultado dependerá de la configuración y la carga de trabajo.
Las primeras pruebas muestran diferencias importantes entre escenarios. Lambda obtuvo un 24% más de rendimiento en tokens y pudo disponer de un 19% más de capacidad GPU dentro de un presupuesto eléctrico fijo utilizando sistemas HGX B200. Nscale, en una evaluación realizada con cuatro racks GB300 NVL72 en Islandia, registró un 49% más de rendimiento de inferencia y un 37% más de GPU gestionadas manteniendo un límite de 264 kW. Son resultados de pruebas concretas, no una mejora uniforme aplicable a cualquier instalación.
DSX Flex lleva esa gestión al contacto con la red eléctrica. El software permite modificar la demanda de las cargas de IA en función de restricciones de la red, precios o programas de respuesta a la demanda. Una prueba realizada con Emerald AI, EPRI, Nebius, National Grid y NVIDIA consiguió reducir hasta un 40% el consumo de un clúster Blackwell Ultra durante eventos simulados de red manteniendo activas las cargas consideradas críticas.
Para los operadores europeos, esta capacidad tiene una consecuencia práctica. El límite para ampliar un centro de datos está dejando de ser exclusivamente el número de aceleradores disponibles. La potencia eléctrica contratada, los plazos de conexión a la red y la capacidad de refrigeración condicionan cada vez más la cantidad de computación que puede entrar en servicio.
NVIDIA también está trasladando esa optimización al consumo de agua. Los diseños DSX combinan refrigeración líquida en circuito cerrado con sistemas exteriores de refrigeración seca, similares a grandes radiadores. Con Vera Rubin, que admite refrigeración líquida completa y temperaturas de refrigerante de hasta 45 grados, la compañía sostiene que algunas instalaciones podrán acercarse a un consumo nulo de agua para refrigeración del edificio.
En un centro de 2 GW, NVIDIA calcula un ahorro de hasta 54 millones de litros diarios frente a una instalación basada en torres de refrigeración evaporativa. La propia arquitectura contempla que el resultado depende del clima local y que durante los periodos de mayor temperatura puede ser necesaria refrigeración mecánica adicional.
Centros de datos fabricados antes de llegar al emplazamiento
El tercer anuncio modifica el proceso de construcción. DSX POD es un diseño de referencia para desplegar sistemas Vera Rubin dentro de módulos prefabricados que llegan al emplazamiento con buena parte de la integración ya realizada.
En lugar de instalar y cablear racks, redes, distribución eléctrica y refrigeración líquida completamente sobre el terreno, los socios pueden ensamblar y validar los módulos en fábrica mientras avanzan paralelamente las obras del emplazamiento. NVIDIA estima que, una vez preparado el lugar, este sistema puede reducir el despliegue desde aproximadamente seis meses hasta un mínimo de 14 días.
Bull, Dell Technologies, HPE, Lenovo, Schneider Electric, Vertiv y otros fabricantes e integradores trabajan en sistemas basados en la arquitectura, cuya disponibilidad está prevista a partir de comienzos de 2027.
La reducción del plazo tiene una dimensión financiera además de técnica. Un centro de datos de IA empieza a generar ingresos cuando sus aceleradores pueden ejecutar cargas de entrenamiento o inferencia. Acortar el intervalo entre la inversión en infraestructura y la entrada en producción permite aumentar antes la utilización de unos equipos cuyo coste de capital es elevado.
Esa lógica conecta los distintos anuncios realizados en Berlín. Los nuevos modelos amplían las cargas que NVIDIA quiere ejecutar sobre su plataforma; DSX trata de extraer más computación de una cantidad limitada de energía, agua e infraestructura, y DSX POD busca reducir el tiempo necesario para añadir esa capacidad.
Para Europa, donde la disponibilidad energética, la conexión a la red y los requisitos de control sobre los datos condicionan nuevos proyectos de IA, NVIDIA está construyendo una propuesta que va bastante más allá de vender GPU. La compañía quiere proporcionar buena parte de la arquitectura sobre la que empresas, operadores y administraciones desplieguen su propia capacidad de inteligencia artificial. El grado de soberanía resultante dependerá, precisamente, de hasta qué punto esas organizaciones puedan combinar ese ecosistema con modelos, software e infraestructuras de otros proveedores.