

Microsoft ampliará Azure Maia a despliegues de varios gigavatios a partir de 2027, una escala con la que pretende convertir sus aceleradores propios en la infraestructura principal para ejecutar la inferencia de inteligencia artificial de productos como Copilot y otros servicios de la compañía. El movimiento sitúa el diseño de chips propios en una posición mucho más central dentro de Azure y responde a una de las restricciones que está marcando la expansión de la IA: cuánta capacidad útil puede obtenerse por cada megavatio disponible.
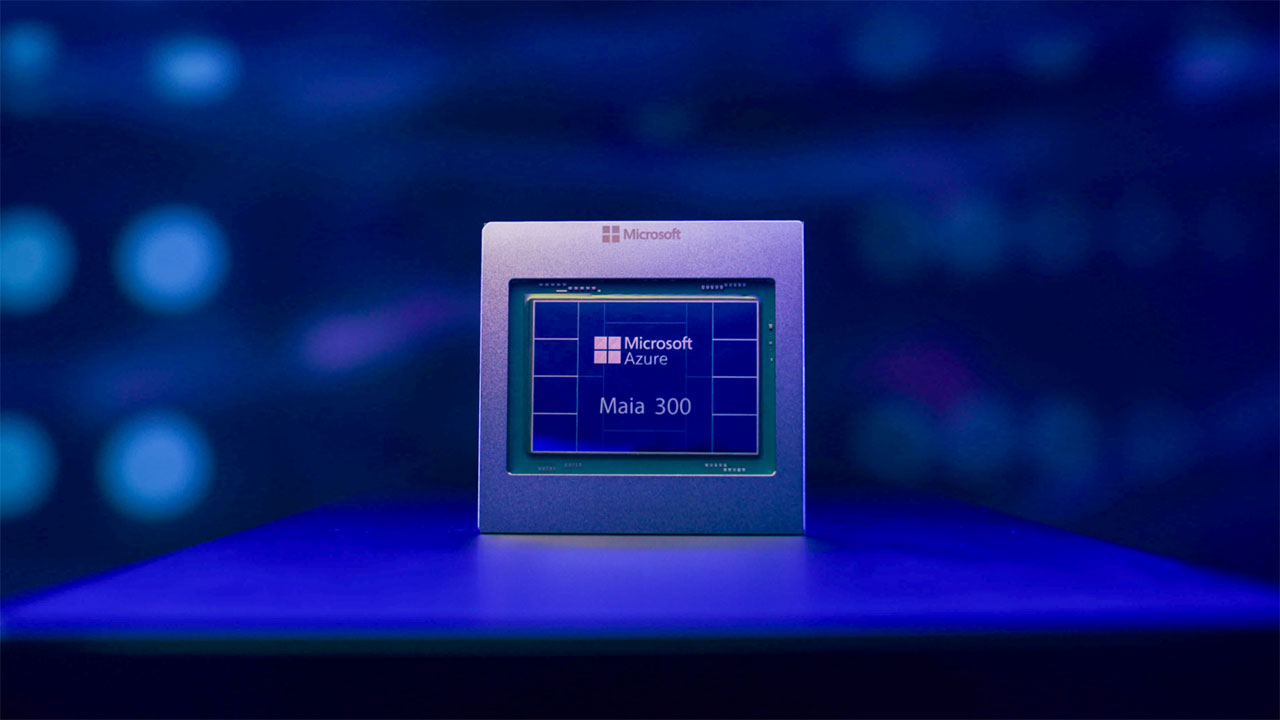
La compañía acompañará ese crecimiento con Maia 300, la tercera generación de su familia de aceleradores, cuyos primeros despliegues de producción están previstos para 2027. Microsoft calcula que el nuevo sistema podrá procesar un 40% más de tokens por megavatio que los principales sistemas basados en GPU y alcanzar, en una configuración completa de 96 aceleradores, hasta siete veces el rendimiento de Maia 200 a escala de rack. Son estimaciones del fabricante y, por ahora, no existen pruebas independientes que permitan comparar ambos entornos en cargas equivalentes.
El objetivo declarado es utilizar Maia como principal sistema de inferencia de los productos y servicios de Microsoft. La dimensión del proyecto refleja hasta qué punto la infraestructura de IA está dejando de organizarse únicamente alrededor de la potencia de cálculo de cada procesador para incorporar energía, memoria, red y densidad de los centros de datos como variables del mismo problema.

Maia 200 ya ejecuta cargas de Copilot
El paso hacia Maia 300 llega mientras su predecesor comienza a asumir cargas reales dentro de Microsoft. Maia 200 ya se utiliza en Microsoft Copilot y sirve también al equipo Microsoft AI para el desarrollo de modelos. La compañía prevé extenderlo a GitHub Copilot y Microsoft Foundry antes de terminar 2026.
Sobre el acelerador se ejecutan modelos de OpenAI, modelos propios de la familia MAI y arquitecturas de código abierto. Esta diversidad resulta relevante para la estrategia de Microsoft: Maia se plantea como infraestructura especializada para inferencia, pero dentro de una plataforma Azure que seguirá combinando silicio propio con aceleradores de Nvidia, AMD y otros proveedores.
Maia 200, presentado en enero, está fabricado con el proceso de 3 nanómetros de TSMC e integra 216 GB de memoria HBM3e, con un ancho de banda de 7 TB/s, además de 272 MB de SRAM. Microsoft situó entonces su mejora de rendimiento por dólar en un 30% frente a los sistemas que ya utilizaba.
Los despliegues se están extendiendo por Estados Unidos, Europa y Australia. Microsoft atribuye a Maia 200 hasta 1,7 veces más tokens por vatio para determinadas funciones integradas en Teams, Copilot y Cowork frente a infraestructuras basadas en GPU de referencia.
De nuevo, se trata de cifras internas, pero anticipan el criterio que la empresa está utilizando para diseñar la siguiente generación: maximizar la cantidad de trabajo de inferencia que puede realizarse dentro de unos límites energéticos concretos.
Ese enfoque gana importancia a medida que las aplicaciones incorporan contextos más largos y agentes capaces de mantener procesos de varios pasos. Estos escenarios requieren conservar y mover grandes cantidades de información durante la generación, de manera que el ancho de banda de memoria y las comunicaciones entre aceleradores pueden convertirse en cuellos de botella tanto como la capacidad aritmética del chip.
Azure Maia 300 pone el foco en memoria y movimiento de datos
Maia 300 estará diseñado específicamente para cargas de inferencia con contextos largos, uso intensivo de memoria, generación secuencial de tokens y tareas agénticas prolongadas. En lugar de tratar cada procesador como una unidad independiente, Microsoft plantea el rack y la red que conecta los chips como partes del mismo sistema de cálculo.
Cada acelerador contará con ocho pilas HBM4 capaces de proporcionar 18 TB/s de ancho de banda máximo dentro de un TDP de 950 vatios. La memoria SRAM integrada podrá utilizarse como espacio temporal gestionado por software para reducir accesos a HBM, una característica orientada a limitar los movimientos de datos que consumen energía y pueden reducir la utilización de las unidades de cálculo.
La arquitectura recurrirá además a varios chiplets. Las funciones de cálculo, control de memoria y entrada y salida estarán separadas físicamente, mientras que los chiplets de computación se fabricarán mediante el proceso N2P de TSMC. El planteamiento permite emplear tecnologías de fabricación distintas para diferentes partes del sistema y ajustar mejor coste, consumo y prestaciones.
Microsoft también incorporará formatos numéricos de baja precisión como una versión ampliada de MXFP4. Reducir el número de bits necesario para determinadas operaciones y para almacenar la caché KV permite contener las necesidades de memoria de los modelos y aumentar el volumen de contexto procesable con la misma infraestructura, siempre que la reducción de precisión mantenga una calidad suficiente para la carga de trabajo.
La evolución parte de un programa de silicio propio iniciado públicamente con Maia 100 en 2023. Aquella primera generación ya combinaba acelerador, refrigeración líquida, distribución de potencia, software y una red Ethernet específica. Microsoft planteó desde el principio Maia como un diseño conjunto de hardware y software para Azure, una estrategia similar a la seguida por otros grandes operadores cloud que desarrollan procesadores para sus propias cargas.
Racks de 167 kW y 96 aceleradores
El salto de escala aparece con claridad en la configuración física de Maia 300. Cada rack podrá integrar 96 aceleradores dentro de un presupuesto eléctrico de 167 kW, con 27,6 TB de memoria HBM y un ancho de banda agregado de 1,7 PB/s.
La interconexión es otro componente central. Microsoft utilizará enlaces de alta capacidad entre aceleradores y un transporte específico para IA apoyado en infraestructura Ethernet. El propósito es extender el mismo dominio de comunicación desde un único rack hasta instalaciones de centro de datos, evitando que la red introduzca un límite adicional cuando un modelo se distribuye entre numerosos chips.
La compañía espera que esa densidad permita atender más sesiones simultáneas y modelos de mayor tamaño sin aumentar de manera proporcional el consumo eléctrico. Esa relación entre tokens generados, potencia consumida y espacio físico se ha convertido en una variable económica directa para los proveedores de nube: ampliar la capacidad de IA exige disponer no solamente de aceleradores, sino también de suministro eléctrico, refrigeración y redes capaces de sostenerlos.
El volumen previsto muestra la dimensión financiera de esa carrera. Reuters informa de que Microsoft contempla despliegues que podrían superar el millón de unidades de Maia 300 durante 2027, dentro de un programa de infraestructura que se mueve ya en magnitudes de varios gigavatios. La compañía ha situado además su gasto de capital previsto para el año natural en más de 175.000 millones de dólares.
La expansión de Maia tampoco implica que Azure abandone las GPU comerciales. Microsoft mantiene acuerdos de infraestructura con Nvidia y AMD, mientras construye una capa propia para aquellas cargas que puede optimizar de extremo a extremo. La ventaja potencial está en controlar conjuntamente procesador, software, red y aplicación y reducir el coste de servicios que operan continuamente a enorme escala.
Para los clientes empresariales, el efecto inmediato será principalmente indirecto. Maia 300 comenzará atendiendo infraestructura y servicios de Microsoft, pero la reducción del coste por token y la disponibilidad de capacidad condicionan posteriormente precios, límites de consumo, latencia y velocidad de despliegue de servicios de IA en la nube. Con la electricidad y la capacidad de los centros de datos convertidas en restricciones de primer orden, Microsoft está trasladando la competencia entre aceleradores desde la potencia máxima de cada chip hacia la cantidad de inferencia que puede obtener de cada rack y de cada megavatio.