
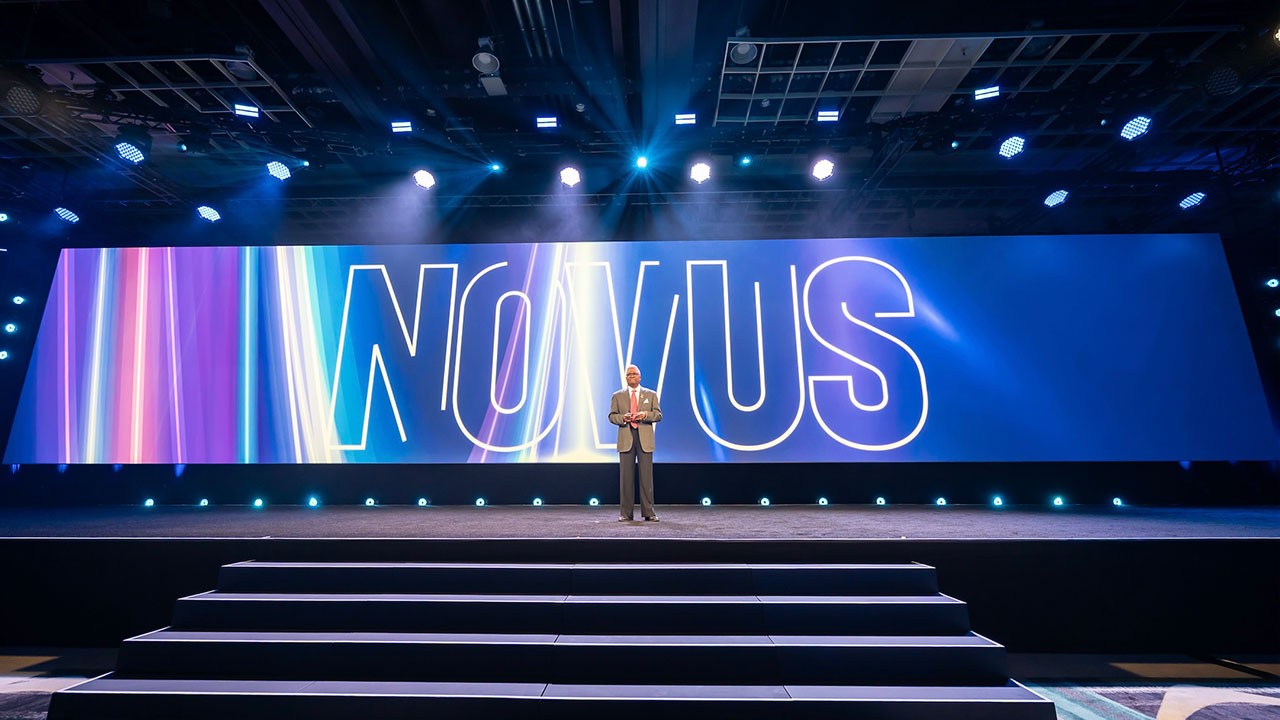

NetApp ha presentado Novus, una nueva arquitectura de almacenamiento orientada a grandes infraestructuras de inteligencia artificial que pretende resolver uno de los problemas que aparecen cuando los despliegues de GPU crecen hasta cientos de miles de aceleradores: mantener un flujo de datos suficiente para que la capacidad de cómputo permanezca ocupada.
La compañía sitúa el objetivo de NetApp Novus en instalaciones como neoclouds, proveedores de GPU como servicio y grandes «factorías de IA», donde el coste de los aceleradores convierte su grado de utilización en una variable económica crítica. La arquitectura está diseñada para superar los 100 TB por segundo de rendimiento agregado y evolucionar hacia sistemas de archivos a escala de zettabytes, aunque esa cifra representa la capacidad prevista del diseño a gran escala y no el rendimiento medido de una única instalación comercial de esas dimensiones.
La propuesta parte de una limitación conocida en los grandes clústeres de IA. Añadir GPU no garantiza que aumente proporcionalmente el rendimiento si los sistemas que almacenan y sirven los conjuntos de datos, checkpoints y otros archivos necesarios para entrenar o ejecutar modelos no pueden suministrarlos con suficiente velocidad y concurrencia. NetApp sostiene que, bajo determinadas arquitecturas tradicionales, la utilización de las GPU puede caer por debajo del 30% cuando el almacenamiento se convierte en el cuello de botella.
Ese porcentaje procede de la propia compañía y no describe necesariamente el comportamiento de cualquier clúster de IA. Sí refleja, sin embargo, una cuestión que está adquiriendo peso económico a medida que las infraestructuras incorporan más aceleradores: una GPU esperando datos sigue consumiendo inversión, espacio, energía y capacidad de refrigeración aunque no esté realizando trabajo útil.
Separar los metadatos de los datos
Novus modifica la forma de escalar la infraestructura separando la gestión de metadatos de la ruta por la que circulan los propios datos. El objetivo es que capacidad, ancho de banda y operaciones sobre archivos puedan crecer de forma independiente sin dividir la infraestructura en múltiples sistemas de almacenamiento.
Los metadatos contienen información sobre aspectos como la ubicación, estructura y atributos de los archivos. En entornos con miles de millones de objetos y numerosos clientes accediendo simultáneamente al almacenamiento, gestionar esas operaciones puede convertirse en una limitación aunque las unidades donde residen los datos dispongan de ancho de banda suficiente.
NetApp concentra esa función en Novus Data Director, que en la primera implementación se ejecutará sobre servidores certificados de Supermicro. Los datos permanecen en sistemas NetApp AFF A90 gestionados mediante ONTAP. Ambos planos se presentan a las aplicaciones mediante un único espacio de nombres y utilizando NFS, lo que permite ampliar la infraestructura sin exigir un protocolo específico a cada cliente.
La separación permite añadir recursos allí donde aparece la presión. Un operador puede aumentar capacidad sin tener que incrementar en la misma proporción el procesamiento de metadatos, o ampliar ancho de banda cuando el problema está en alimentar más GPU. Para proveedores que comercializan capacidad de cómputo entre múltiples clientes, esa granularidad puede evitar parte del sobredimensionamiento asociado a arquitecturas donde almacenamiento y control crecen como una unidad indivisible.
«Las factorías de IA se ven en apuros y la rentabilidad de las GPU se derrumba cuando los datos no pueden seguir el ritmo», afirma Syam Nair, director de producto de NetApp. La compañía plantea Novus como una alternativa a sistemas de almacenamiento heredados de entornos HPC que, según su planteamiento, encuentran dificultades cuando deben combinar una elevada concurrencia, escalabilidad de capacidad y servicios empresariales dentro de un mismo entorno.
Los 100 TB/s dependen de escalar la arquitectura
Uno de los principales argumentos de NetApp es un rendimiento agregado superior a 100 TB/s. La cifra requiere una lectura diferente a la de la velocidad de una cabina individual. Novus está concebido como una arquitectura distribuida en la que numerosos clústeres ONTAP pueden incorporarse bajo el mismo espacio de nombres.
Omdia asegura haber observado un incremento de rendimiento casi lineal al añadir clústeres durante sus pruebas. A partir de esos resultados, sus modelos proyectan que el diseño desagregado puede llegar a 100 TB/s de lectura secuencial y a decenas de exabytes de capacidad efectiva, con posibilidad de seguir ampliándose. La previsión, por tanto, extrapola el comportamiento observado y no equivale a una prueba de un despliegue completo de 100 TB/s en producción.
Esta distinción resulta especialmente relevante en un mercado donde las cifras máximas de rendimiento dependen de parámetros como el tamaño y patrón de las operaciones, la red, la distribución de los datos o el número de nodos que participan en la prueba.
NetApp también utiliza el término «zettabyte-scale» para describir la capacidad para la que está diseñada la arquitectura. Un zettabyte equivale a 1.000 exabytes en notación decimal, una escala muy superior a la de la mayoría de instalaciones empresariales actuales. La intención es evitar que el espacio de nombres o el plano de metadatos se conviertan en un límite arquitectónico conforme aumenten los conjuntos de datos.
El coste de una GPU ociosa cambia la economía del almacenamiento
El interés empresarial de Novus está ligado al peso que han adquirido las GPU dentro del coste total de una infraestructura de IA. Para un proveedor de capacidad, mejorar el porcentaje de tiempo durante el que los aceleradores realizan trabajo facturable puede tener un efecto directo sobre los ingresos obtenidos por el mismo equipamiento.
Esa relación está empujando al almacenamiento a ocupar un papel distinto al que tenía en numerosos centros de datos tradicionales. El parámetro relevante deja de ser únicamente cuánto cuesta almacenar cada terabyte. También importa cuánto gasto de computación puede quedar infrautilizado si los datos llegan demasiado despacio.
Mike Leone, vicepresidente y analista principal de Moor Insights & Strategy, vincula precisamente ambas variables: «A medida que los proveedores de infraestructura de IA amplían los entornos de GPU, la rentabilidad depende cada vez más de mantener los recursos de computación plenamente utilizados».
Además del rendimiento, NetApp mantiene en Novus funciones de ONTAP relacionadas con resiliencia, seguridad, gestión y aislamiento entre clientes. Este último aspecto resulta especialmente importante para neoclouds y plataformas de GPU como servicio, donde distintos usuarios pueden compartir la infraestructura física sin compartir sus conjuntos de datos.
Supermicro entra en la primera configuración de Novus
La primera versión comercial combina el software Novus Data Director con infraestructura Supermicro y sistemas AFF A90. Ambas compañías han ampliado su colaboración para desarrollar configuraciones de IA que integren computación, red y almacenamiento, desde despliegues empresariales hasta grandes factorías de IA.
NetApp señala que Novus ya puede encargarse, mientras mantiene una hoja de ruta hacia implementaciones cada vez más definidas por software. El objetivo es conservar el espacio de nombres y el modelo operativo aunque cambie la infraestructura física subyacente.
La compañía también encuadra Novus dentro de una estrategia más amplia para que ONTAP actúe como capa común entre centros de datos, nubes públicas y nuevas infraestructuras de IA. Durante NetApp Insight 2026 ha presentado además nuevas capacidades para activar datos empresariales sin copiarlos previamente y controles de soberanía para determinados clientes europeos, una señal de que rendimiento, gobierno y localización del dato empiezan a tratarse como partes de un mismo problema de infraestructura.
Para los operadores de grandes clústeres, la cuestión será comprobar hasta qué punto el escalado observado en pruebas se mantiene en instalaciones reales con cargas heterogéneas, numerosos usuarios y redes de gran tamaño. Si el almacenamiento puede crecer de forma más independiente que hasta ahora, la planificación de capacidad dejará de obligar a ampliar simultáneamente recursos que una carga concreta quizá no necesita.
El efecto económico se medirá menos por la velocidad máxima publicada que por una métrica más operativa: cuánto tiempo adicional pueden permanecer trabajando unas GPU cuyo coste ya está comprometido.