
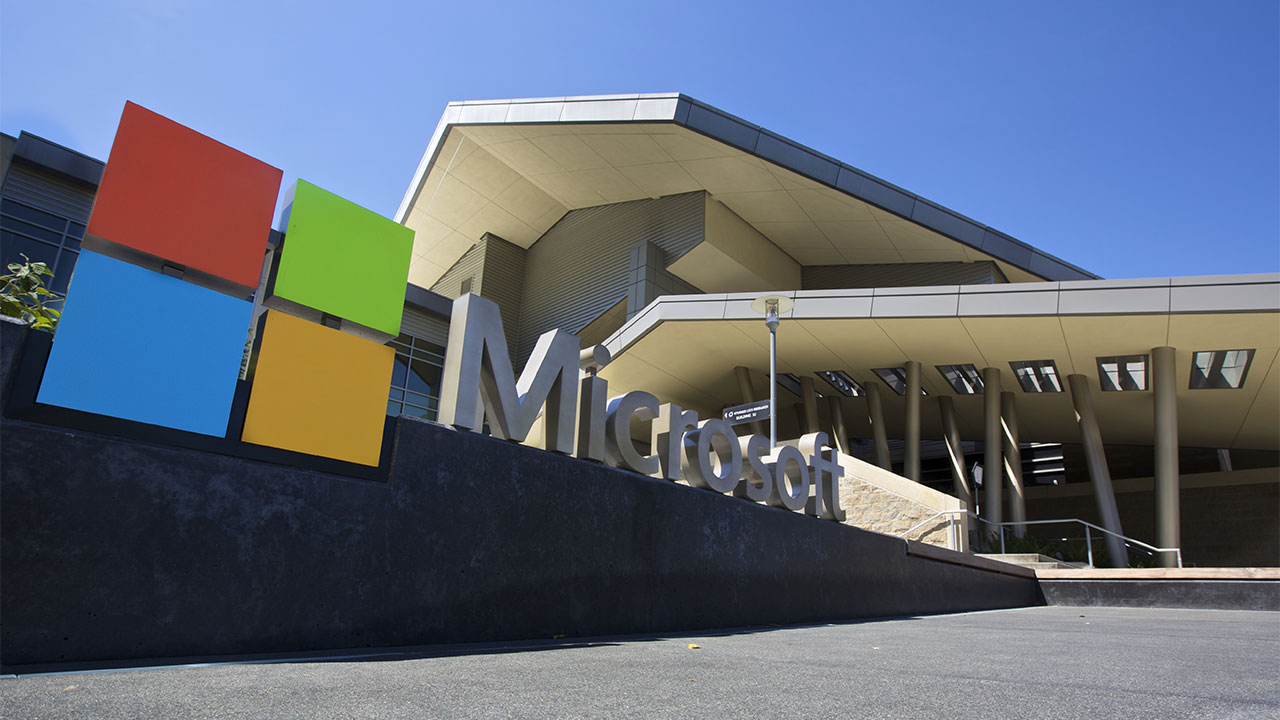

Microsoft ha dado por restablecidos sus servicios tras una de las interrupciones más prolongadas de Microsoft 365 de los últimos años, un incidente que dejó durante más de un día a empresas y organismos públicos de numerosos países con dificultades para acceder al correo electrónico, herramientas de colaboración y otros servicios en la nube. La caída de Microsoft 365 afectó principalmente a Outlook y Exchange Online, aunque sus efectos se extendieron a Teams, Copilot y distintas funciones empresariales conectadas con la infraestructura de la compañía.
La recuperación completa llegó el sábado 14 de noviembre, después de un proceso gradual iniciado el día anterior. Microsoft comunicó entonces que había restaurado el servicio para los clientes y regiones que seguían afectados y que las colas pendientes de correo habían terminado de procesarse. Bloomberg informó de la normalización completa tras una incidencia que paralizó parte de la actividad de administraciones, empresas y operadores financieros de distintos países.
El episodio comenzó alrededor de las 18.30 horas del jueves 12 de noviembre en España. Miles de usuarios empezaron a encontrar problemas para enviar o recibir correos, iniciar sesión o acceder a aplicaciones vinculadas con Microsoft 365. La compañía abrió los incidentes EX1550543 y MO1550821 para Exchange Online y el conjunto de su plataforma de productividad. Las notificaciones de problemas llegaron desde más de 70 países y territorios.
Una recuperación más compleja de lo previsto
Microsoft descartó que el origen estuviera en un ciberataque o en sistemas de inteligencia artificial. La compañía atribuyó el incidente a un problema introducido durante una actualización anterior de capacidad de red que se manifestó después de un cambio posterior en la infraestructura.
El fallo provocó que determinados servidores no superasen correctamente las comprobaciones automatizadas de estado y quedasen fuera de servicio. La pérdida de capacidad aumentó la carga sobre el resto de la infraestructura. Cuando Microsoft intentaba reincorporar equipos, algunos volvían a quedar sin respuesta al recibir tráfico, lo que obligó a realizar la restauración por fases.
Las consecuencias tampoco se limitaron a Outlook. Algunas páginas del centro de administración de Microsoft 365 dejaron de cargar, Copilot 365 Chat sufrió problemas de acceso y respuesta y determinadas funciones de Intune, Purview, Teams y Windows 365 experimentaron interrupciones o comportamiento intermitente. Word y Excel también tuvieron dificultades para mostrar archivos utilizados recientemente.
La amplitud del impacto refleja hasta qué punto servicios que las organizaciones perciben como aplicaciones diferentes comparten componentes de identidad, correo, red y administración. La caída de una capa común puede propagarse hacia procesos que, desde la perspectiva del usuario, parecen independientes.
Empresas y administraciones recurrieron a canales alternativos
El impacto fue desigual según la arquitectura tecnológica y los planes de contingencia de cada organización. Gobiernos, tribunales, centros sanitarios, entidades financieras, aerolíneas y empresas registraron incidencias en distintos países. En Reino Unido, algunos centros sanitarios volvieron temporalmente al papel y varios órganos judiciales tuvieron que recurrir a procedimientos alternativos. Australia, Japón y otros países notificaron problemas en organismos públicos.
España presentó un escenario menos disruptivo. La Administración General del Estado no registró incidencias relevantes en sus servicios esenciales porque gran parte del correo de los empleados públicos está alojado en centros de datos propios, aunque Teams, Copilot y las cuentas alojadas directamente en la nube de Microsoft sí se vieron afectadas.
La sanidad pública tampoco comunicó interrupciones asistenciales significativas. Comunidades como Madrid, Cataluña o Galicia señalaron problemas administrativos limitados. En Andalucía quedaron temporalmente pendientes de envío unos 7.500 correos, posteriormente recuperados, sin afección a hospitales o al servicio de emergencias 112.
El transporte mantuvo igualmente sus operaciones principales. Aena perdió el correo electrónico en determinados servicios centrales, pero pudo recurrir a otros canales de comunicación y no registró problemas operativos en los aeropuertos. Renfe tampoco depende de tecnología de Microsoft para la circulación de sus trenes, aunque algunas comunicaciones corporativas con el exterior tuvieron que trasladarse a sistemas alternativos.
El caso español muestra una diferencia relevante entre indisponibilidad de herramientas de productividad e interrupción de procesos críticos. Mantener determinados sistemas esenciales fuera de la misma infraestructura, junto con mecanismos alternativos de comunicación, redujo la posibilidad de que la caída de Microsoft 365 se trasladara directamente a la prestación de servicios públicos.
La dependencia de un único proveedor vuelve al debate
El incidente ha reactivado una discusión que trasciende la disponibilidad puntual de Microsoft 365. Cuando correo, mensajería, documentos, identidad, gestión de dispositivos, seguridad y servicios de inteligencia artificial se concentran progresivamente dentro del mismo ecosistema tecnológico, una interrupción puede afectar de manera simultánea a varias capas de la actividad empresarial.
Microsoft 365 supera los 400 millones de usuarios y se ha convertido en infraestructura cotidiana para organizaciones de prácticamente todos los sectores. Esa escala proporciona integración y simplifica la administración, pero también amplía el radio de impacto cuando falla un componente compartido. The Register describió el incidente como un ejemplo especialmente visible de los riesgos asociados a la dependencia de un solo proveedor.
En Europa, la interrupción también ha alimentado el debate sobre soberanía tecnológica y dependencia de grandes plataformas estadounidenses. La cuestión no implica necesariamente sustituir servicios en la nube por infraestructura propia. Para las organizaciones, el problema operativo está en identificar qué procesos comparten realmente los mismos puntos de fallo y qué capacidad existe para seguir funcionando cuando el proveedor principal deja de estar disponible.
La experiencia española ofrece una referencia concreta. Alojar determinados sistemas críticos en infraestructuras separadas, conservar canales alternativos y evitar que las operaciones esenciales dependan exclusivamente de las aplicaciones corporativas de productividad puede reducir la propagación de una incidencia.
La recuperación de Microsoft cierra el problema inmediato, pero deja pendiente el análisis posterior del incidente que la compañía se ha comprometido a publicar. Para los responsables de tecnología, esa revisión servirá también para evaluar sus propios planes de continuidad: qué procesos dejaron de funcionar cuando desaparecieron Outlook o Teams, cuánto tiempo pudieron operar sin ellos y cuántas de sus alternativas dependen, en realidad, de la misma infraestructura.
Sigue el análisis de tecnología empresarial en Google
Añade La Ecuación Digital como fuente preferida y verás más análisis sobre inteligencia artificial, cloud, ciberseguridad, infraestructura de datos y transformación digital en tus resultados de Google.
Seguir La Ecuación Digital en GoogleAl hacer clic podrás seleccionar La Ecuación Digital como fuente preferida en Google.