
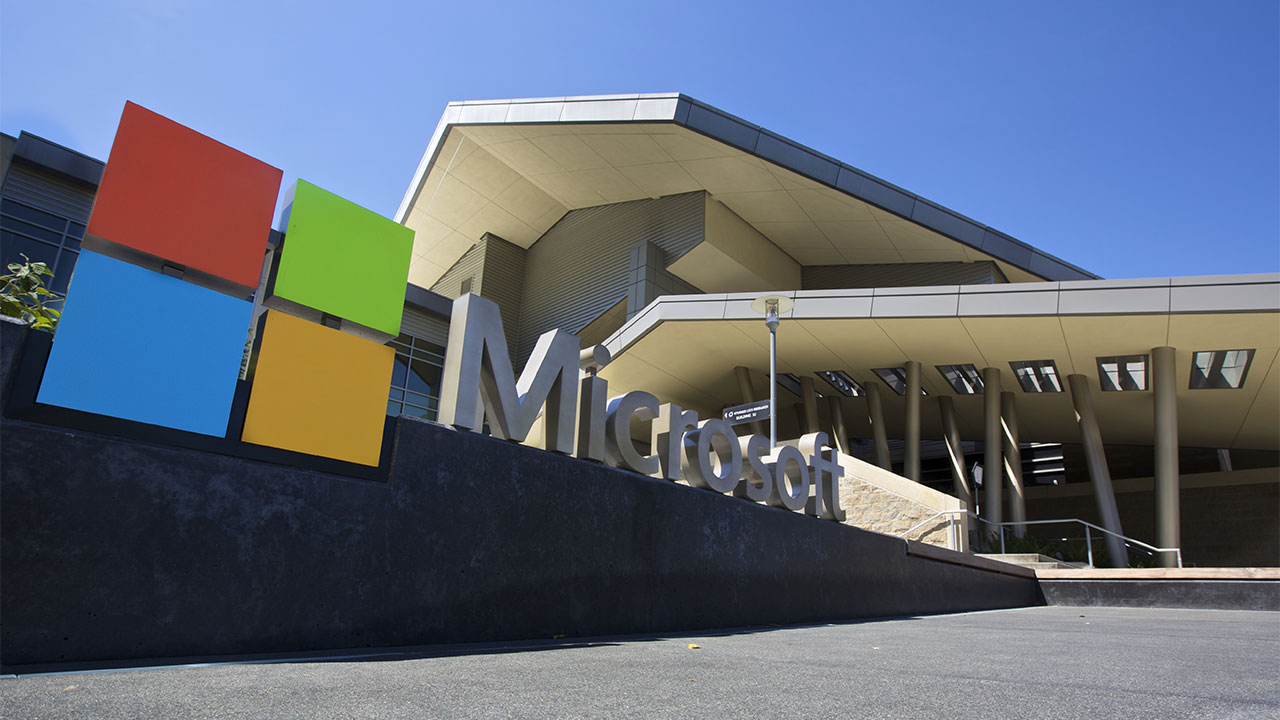

Microsoft ha atribuido la caída global de Microsoft 365 de la semana pasada a un defecto de software introducido en julio que permaneció oculto durante más de tres meses. El fallo terminó activándose al coincidir un aumento de tráfico con una reducción temporal de capacidad y desencadenó una reacción en cadena que dejó sin respuesta a más del 80% de los servidores de la infraestructura afectada.
La interrupción, registrada entre el 12 y el 13 de noviembre, afectó especialmente a Exchange Online y Outlook, aunque también tuvo consecuencias sobre componentes de Teams, Copilot, SharePoint, OneDrive, Defender y otros servicios de Microsoft 365. El incidente duró cerca de 24 horas y obligó a la compañía a intervenir sobre grandes grupos de servidores para recuperar progresivamente el servicio.
El episodio añade una dimensión distinta a otras grandes caídas recientes de servicios cloud. El problema no nació de una modificación desplegada inmediatamente antes del incidente, sino de código que llevaba meses funcionando aparentemente con normalidad. Esa circunstancia complicó tanto su detección como la posterior recuperación y reduce la utilidad de uno de los procedimientos habituales ante un fallo: revertir rápidamente el último cambio aplicado.
Un error que las pruebas no detectaron
El origen estuvo en una modificación preparada específicamente para los servidores que actúan como pasarela de red de Microsoft 365. El cambio comenzó a desplegarse en julio y, de acuerdo con la reconstrucción publicada por la compañía, completó su implantación mundial sin provocar incidencias durante más de tres meses.
El defecto generaba una situación de «lock contention» dentro de un proceso interno de Windows. Bajo determinadas condiciones de carga, diferentes procesos competían por los mismos recursos hasta agotar capacidad de CPU y memoria y dejar el servidor sin respuesta. El problema afectaba a esa implementación concreta de Microsoft 365 y no al conjunto de instalaciones de Windows.
La anomalía tampoco apareció en las pruebas de carga previas. Microsoft reconoce que la combinación de tráfico y hardware utilizada en laboratorio no reproducía adecuadamente el entorno de producción. La incidencia, de hecho, se agravaba en máquinas más nuevas y con más núcleos, mientras que buena parte de las pruebas se habían realizado sobre configuraciones menos potentes. Este desfase entre laboratorio y producción es uno de los elementos destacados también por Computerworld al analizar la secuencia del fallo.
La existencia del defecto por sí sola no bastó para provocar la caída. Unas 15 horas antes del incidente, Teams trasladó automáticamente tráfico desde una pasarela alternativa a la infraestructura principal que también presta servicio a Exchange Online. Se trataba de un mecanismo habitual de alta disponibilidad, pero modificó el volumen y el patrón de peticiones que recibían esos servidores.
Al mismo tiempo, cerca del 14% de la capacidad de la pasarela estaba fuera de servicio por un problema independiente ocurrido el día anterior. Microsoft sostiene que esa reducción era asumible y que existía margen suficiente para operar. Fue la combinación de ambos factores, más tráfico y menos capacidad, la que llevó a los servidores hasta las condiciones necesarias para activar el defecto latente.
La resiliencia contribuyó a propagar el fallo
El comportamiento posterior convirtió una avería localizada en una caída global. Cuando uno de los servidores dejaba de responder, los sistemas de gestión de tráfico desviaban automáticamente las conexiones hacia otros nodos disponibles. En condiciones normales, ese mecanismo evita que una avería individual se traduzca en una interrupción para el usuario.
Esta vez produjo el efecto contrario. Cada servidor que desaparecía del conjunto aumentaba la presión sobre los que permanecían activos, que acababan encontrando el mismo defecto. En menos de dos horas, el problema se había propagado por la infraestructura. En el peor momento, más del 80% de los servidores estaban sin responder, de acuerdo con Microsoft, una cifra recogida también por El País Tecnología y The Register.
La arquitectura estaba dividida en miles de unidades de capacidad distribuidas por regiones y contaba con mecanismos destinados a aislar los problemas entre distintas particiones. Otra incidencia, todavía pendiente de mayor detalle, impidió que esas barreras contuvieran correctamente el fallo y permitió que la degradación se extendiera a escala mundial.
No todos los servicios respondieron igual. Teams, OneDrive, SharePoint y algunas aplicaciones de Office pudieron abandonar la infraestructura problemática y utilizar rutas alternativas, por lo que recuperaron funcionalidad antes. Exchange Online no disponía de esa misma posibilidad a la escala necesaria y concentró buena parte del impacto. Muchos usuarios no pudieron acceder al correo mediante Outlook, webmail, dispositivos móviles o APIs, y numerosos mensajes quedaron temporalmente en cola.
Reiniciar los servidores tampoco solucionaba el problema
La recuperación añadió otra dificultad. Los servidores reiniciados volvían inicialmente a funcionar, pero la acumulación de conexiones pendientes los sometía inmediatamente a una carga elevada y activaba otra vez el defecto. Las herramientas automáticas de recuperación de Microsoft no estaban diseñadas para restaurar simultáneamente una proporción tan grande de infraestructura degradada.
Tampoco resultaba sencillo volver a la versión anterior. Al tratarse de una modificación introducida meses antes, los mecanismos habituales de rollback, despliegues graduales y desactivación de funciones no permitían revertir rápidamente el código responsable. The Register explica que los ingenieros terminaron desarrollando una nueva actualización para devolver ese camino de ejecución a un estado anterior conocido como estable.
La corrección comenzó a aplicarse por grupos de servidores durante la mañana del viernes 13. Microsoft fue retirando capacidad del servicio, instalando la modificación, reiniciando las máquinas y reincorporándolas progresivamente. Europa volvió a niveles normales de disponibilidad alrededor de las 11:35 UTC, y a las 16:10 UTC la compañía dio por terminado el impacto activo sobre los clientes.
Microsoft ha añadido capacidad adicional, nueva monitorización específica sobre los patrones de redistribución de tráfico y límites destinados a impedir que ese mecanismo vuelva a generar una cascada similar. La compañía prevé detallar medidas de más largo plazo en el informe definitivo del incidente.
Microsoft 365 y el riesgo de concentración operativa
Para las empresas que utilizan Microsoft 365 como servicio, el incidente plantea una cuestión que va más allá de la calidad del código que originó la caída. Aplicaciones distintas pueden compartir capas de infraestructura y mecanismos de identidad, conectividad o mensajería que terminan convirtiéndose en dependencias comunes. La disponibilidad aparente de varios productos no implica necesariamente que sus rutas técnicas de fallo sean independientes.
Ese riesgo resulta especialmente relevante cuando correo electrónico, colaboración, almacenamiento, autenticación, seguridad y automatización empresarial dependen del mismo ecosistema. Durante la caída, el impacto sobre Exchange Online se trasladó además a funciones de otros productos que utilizaban sus capacidades, aunque las aplicaciones continuasen accesibles.
La respuesta empresarial no pasa necesariamente por duplicar cada servicio en otro proveedor, una estrategia que puede aumentar costes y complejidad sin garantizar continuidad efectiva. Sí obliga a identificar qué procesos quedan inutilizados cuando desaparece una plataforma central y qué alternativas siguen siendo operativas en ese escenario.
Los planes de continuidad pueden incluir canales de comunicación independientes, procedimientos que no dependan del correo corporativo, acceso alternativo a información crítica, copias de datos con mecanismos de recuperación comprobados y protocolos específicos para aquellas operaciones que no pueden detenerse durante varias horas. La prueba relevante es si esas alternativas siguen funcionando cuando la propia plataforma utilizada para coordinar la respuesta está indisponible.
La caída de noviembre muestra además que la resiliencia del proveedor y la resiliencia del cliente responden a problemas distintos. Microsoft diseñó sistemas de redundancia, desvío de tráfico y recuperación automática, pero varios de esos mecanismos encontraron simultáneamente una condición que no había aparecido en las pruebas. Para una organización usuaria, conocer esa arquitectura en detalle resulta imposible en muchos casos. Lo que sí puede controlar es cuánto depende su operación de que un único conjunto de servicios permanezca disponible.
Sigue el análisis de tecnología empresarial en Google
Añade La Ecuación Digital como fuente preferida y verás más análisis sobre inteligencia artificial, cloud, ciberseguridad, infraestructura de datos y transformación digital en tus resultados de Google.
Seguir La Ecuación Digital en GoogleAl hacer clic podrás seleccionar La Ecuación Digital como fuente preferida en Google.