

Salesforce ha ampliado Agent Fabric, su capa de control para gestionar agentes de inteligencia artificial, con nuevas funciones destinadas a evaluar su comportamiento en producción, detectar problemas en las API de las que dependen y limitar el gasto asociado a su funcionamiento. La actualización introduce Agent Evals y API Evals y refuerza las herramientas financieras de una plataforma que, según la compañía, procesa más de 1.200 millones de solicitudes cada día.
El movimiento responde a un problema que empieza a cobrar peso a medida que los agentes pasan de las pruebas a procesos empresariales reales: supervisarlos exige controlar simultáneamente la calidad de las respuestas, las aplicaciones y modelos a los que acceden, el consumo de recursos y las políticas que determinan qué pueden hacer.
Salesforce intenta reunir esas funciones en un mismo plano de control, independientemente de la plataforma sobre la que se haya construido cada agente. Algunas de las nuevas capacidades todavía no están disponibles de forma general y llegarán durante enero de 2027.
Agent Fabric incorpora evaluaciones continuas
La principal novedad es Agent Evals, una herramienta diseñada para generar pruebas antes del despliegue y seguir evaluando posteriormente agentes, modelos de lenguaje y servidores MCP en producción.
Las empresas pueden definir umbrales de calidad y asociar a ellos medidas concretas. Si un agente deja de alcanzar los niveles establecidos, Agent Fabric puede notificar al responsable, iniciar su puesta en cuarentena o recurrir al denominado Agent Kill Switch para interrumpir su actividad. Las organizaciones pueden configurar estas intervenciones para que requieran aprobación humana antes de ejecutarse.
El cambio desplaza parte de la evaluación desde las fases previas al lanzamiento hacia la operación cotidiana. Esta diferencia resulta relevante cuando los agentes utilizan componentes que evolucionan de manera independiente, desde modelos actualizados por sus proveedores hasta fuentes de datos, herramientas externas o instrucciones internas modificadas después del despliegue.
Un estudio de LangChain realizado entre más de 1.300 profesionales muestra hasta qué punto las evaluaciones en producción todavía están lejos de ser universales. Un 52,4% de las organizaciones encuestadas ejecutaba evaluaciones offline, mientras que el porcentaje que utilizaba evaluaciones online sobre interacciones reales se situaba en el 37,3%. Entre las compañías que ya tenían agentes en producción, esa proporción ascendía al 44,8%.
La supervisión continua permite detectar degradaciones que una batería inicial de pruebas puede no anticipar. Salesforce utiliza como ejemplo un comercio que sustituye el modelo de su agente de atención sobre pedidos por otro más barato. Tras el cambio, Agent Evals detecta respuestas incorrectas sobre pedidos retrasados y solicita autorización para aislar al agente. El equipo puede modificar sus instrucciones, repetir las pruebas y devolverlo después a producción.
El ejemplo ilustra también una de las dificultades operativas de los sistemas agénticos: una reducción del coste por inferencia no garantiza que el coste global del proceso disminuya si la calidad empeora y genera errores, revisiones humanas o incidencias con clientes.
Las API entran en el sistema de evaluación
El segundo componente, API Evals, extiende este enfoque a las interfaces que los agentes utilizan para interactuar con aplicaciones empresariales.
La herramienta genera pruebas funcionales y de rendimiento a partir de las especificaciones de las API. Su propósito es identificar cambios incompatibles antes de que alcancen el entorno de producción. Para un agente que consulta inventario, modifica un pedido o accede a información de un cliente, una alteración en una API puede afectar a su capacidad para completar una tarea aunque el modelo de IA y sus instrucciones continúen funcionando correctamente.
Esta dependencia adquiere más importancia conforme los agentes dejan de limitarse a generar texto y empiezan a ejecutar operaciones mediante herramientas. La evaluación deja entonces de centrarse únicamente en la calidad de la respuesta y pasa a incluir la cadena tecnológica que permite completar cada proceso.
La ampliación también afecta al descubrimiento de esos componentes. Custom Agent Scanner permitirá localizar y catalogar agentes, modelos, servidores MCP y API desplegados en entornos internos, sistemas protegidos por cortafuegos y plataformas que no estén cubiertas de manera nativa. Los activos encontrados pueden incorporarse al Agent Registry de Salesforce sin registrarlos manualmente uno a uno.
Custom Agent Scanner se encuentra actualmente en beta y tiene prevista su disponibilidad general para enero de 2027.
Límites presupuestarios para el consumo de IA
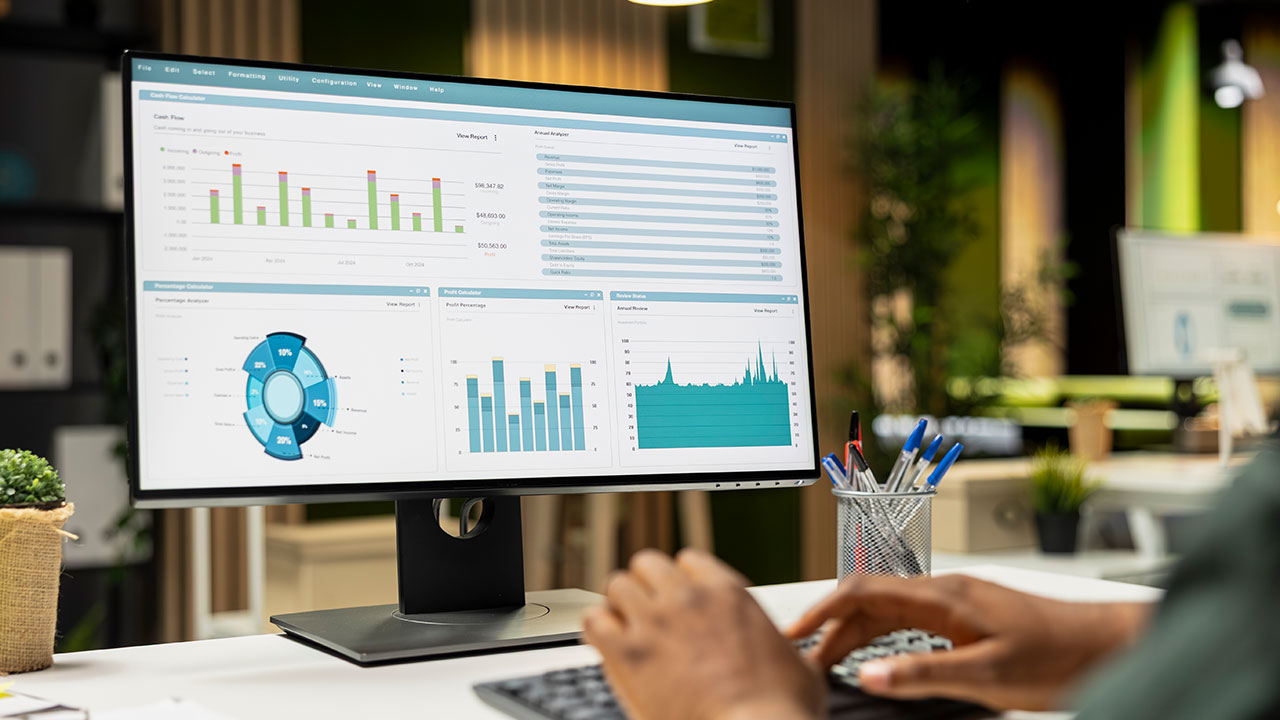
La otra vertiente de la actualización se dirige al control económico. FinOps Dashboard centraliza la visualización del gasto en IA, mientras que Model Wallet permite establecer límites presupuestarios capaces de detener nuevas solicitudes cuando se alcanza el máximo configurado.
Esta capacidad introduce una diferencia respecto a los paneles que se limitan a registrar el consumo una vez producido. Los límites pueden convertirse en una política operativa y evitar que una automatización con un volumen de llamadas superior al previsto siga acumulando costes.
Salesforce incorpora además políticas específicas para controlar los costes de la IA mediante técnicas como caché semántica, compresión de los datos enviados y reducción de las respuestas. La compañía sostiene que estas medidas han reducido el consumo de tokens hasta un 75% en sus escenarios de prueba, una cifra que dependerá del tipo de carga de trabajo y no constituye un nivel de ahorro generalizable a cualquier implementación.
FinOps Dashboard, Model Wallet y Cost Optimization Policies están ya disponibles de forma general.
La combinación de evaluación técnica y FinOps refleja además una característica particular de la IA generativa frente a buena parte del software empresarial tradicional. El coste de una aplicación puede variar con el número y longitud de las interacciones, los modelos utilizados, la cantidad de contexto procesado o las herramientas que un agente invoque durante una tarea. Una desviación de comportamiento puede convertirse así simultáneamente en un problema de calidad y de gasto.
Salesforce extiende el control a pasarelas de terceros
Agent Fabric también amplía su alcance sobre infraestructuras que no pertenecen a Salesforce. La función Open Policies for Federated API Gateways permite descubrir, aplicar y supervisar políticas sobre pasarelas de Azure, Apigee y Kong.
Un administrador puede, por ejemplo, desplegar restricciones por dirección IP o límites de solicitudes sobre varias pasarelas desde una misma acción. La capacidad está ya disponible de forma general.
Salesforce presenta Agent Fabric como una capa común de gobernanza para entornos donde una empresa puede operar agentes procedentes de distintos proveedores. Ese planteamiento intenta resolver uno de los efectos de la fragmentación del mercado: cada plataforma puede aportar sus propios controles, pero los responsables de seguridad, tecnología o costes necesitan aplicar políticas corporativas sobre el conjunto.
Agent Evals y API Evals entran en beta durante noviembre de 2026 y Salesforce prevé lanzarlos de forma general en enero de 2027. El Agent Kill Switch ya está disponible, aunque la posibilidad de activarlo automáticamente para agentes concretos llegará también en enero.
El calendario deja parte de la propuesta todavía pendiente de implantación real en clientes. A corto plazo, las funciones disponibles permiten centralizar gasto, inventario y determinadas políticas, mientras que la evaluación continua y su conexión automática con medidas correctivas se incorporarán progresivamente.
Para las empresas que están trasladando agentes a procesos con impacto sobre clientes u operaciones internas, esa integración determina también cómo evolucionará su modelo de gobierno. Supervisar el modelo empleado será solo una parte del trabajo: habrá que mantener inventarios de agentes y herramientas, fijar métricas de calidad, asignar responsables, establecer presupuestos y decidir qué incidencias justifican una intervención automática y cuáles deben quedar sujetas a aprobación humana.
Sigue el análisis de tecnología empresarial en Google
Añade La Ecuación Digital como fuente preferida y verás más análisis sobre inteligencia artificial, cloud, ciberseguridad, infraestructura de datos y transformación digital en tus resultados de Google.
Seguir La Ecuación Digital en GoogleAl hacer clic podrás seleccionar La Ecuación Digital como fuente preferida en Google.