
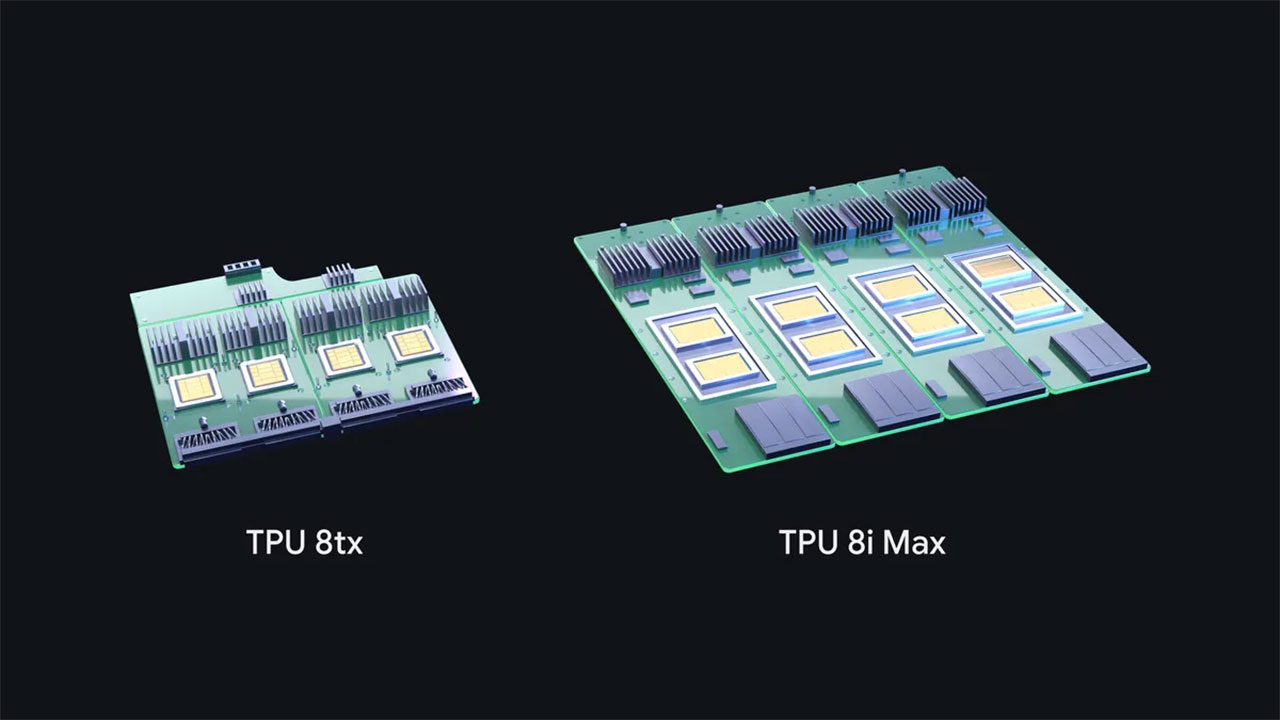

Google ha ampliado su familia de TPU de octava generación con dos nuevos sistemas orientados a cargas de inteligencia artificial que están ganando peso en entornos empresariales: TPU 8tx, centrada en computación confidencial, y TPU 8i Max, diseñada para procesar grandes ventanas de contexto y aumentar la densidad de cómputo en los centros de datos.
La incorporación eleva a cuatro las configuraciones presentadas por Google durante 2026, después de TPU 8t y TPU 8i, y refleja un cambio en la estrategia del grupo. La compañía está utilizando una misma generación de silicio como base para construir sistemas especializados en distintas fases del ciclo de vida de los modelos, desde el entrenamiento a gran escala hasta la inferencia, el razonamiento y la ejecución de agentes con información sensible.
El movimiento llega además cuando Google intenta ampliar el uso de sus aceleradores más allá de sus propios servicios. Las TPUs siguen siendo una pieza de la infraestructura con la que entrena y ejecuta Gemini, pero Google Cloud las ofrece también a clientes externos y ha comenzado a facilitar su despliegue directamente en centros de datos corporativos. La empresa cifra en cerca de un centenar las organizaciones que ya utilizan esta tecnología, entre laboratorios de IA, firmas de trading, distribuidores y universidades.
Cuatro sistemas sobre una misma generación de TPU
TPU 8t y TPU 8i, presentadas en abril, establecieron las dos primeras variantes de esta generación. La primera está orientada al entrenamiento de modelos fundacionales de gran tamaño y, según Google, ofrece hasta 2,7 veces más rendimiento de entrenamiento que su generación precedente. TPU 8i se dirige principalmente a inferencia y razonamiento en tiempo real, con una mejora de hasta el 80% en rendimiento por precio respecto a sistemas anteriores.
Las nuevas TPU 8tx y TPU 8i Max no representan dos arquitecturas de chip completamente independientes. Google está reutilizando el silicio de los sistemas existentes y modificando elementos como el encapsulado, la memoria, la conectividad y la seguridad para responder a cargas concretas.
Esta distinción permite acortar los ciclos de desarrollo. Diseñar un nuevo procesador implica procesos de varios años, mientras que modificar la arquitectura que rodea al chip permite crear configuraciones específicas con mayor rapidez. El planteamiento forma parte de AI Hypercomputer, la arquitectura con la que Google integra aceleradores, CPU, redes, almacenamiento y software para cargas de IA.
Para las empresas, esta especialización apunta a un mercado de aceleradores cada vez menos homogéneo. La infraestructura necesaria para entrenar un modelo de gran escala no presenta exactamente los mismos requisitos que la destinada a mantener cientos de agentes ejecutando inferencias, consultando herramientas externas o trabajando sobre millones de tokens de contexto.
TPU 8tx lleva la computación confidencial al acelerador
TPU 8tx se dirige principalmente a organizaciones reguladas y administraciones públicas que necesitan ejecutar modelos propios o de terceros junto a datos especialmente sensibles.
Uno de los problemas que aborda es la protección de la información mientras está siendo procesada. El cifrado convencional permite proteger los datos almacenados o durante su transmisión, pero las operaciones de cómputo requieren habitualmente acceder a ellos en memoria. La computación confidencial pretende reducir esa exposición mediante mecanismos de aislamiento y protección incorporados al hardware.
Google ha construido TPU 8tx sobre el mismo silicio utilizado en TPU 8t y lo combina con hosts equipados con procesadores AMD EPYC de quinta generación. El sistema mantiene aislados tanto los datos como los pesos de los modelos mientras están en uso y adopta la red Boardfly de baja latencia desarrollada para cargas de razonamiento. Según las mediciones de Google, esta configuración puede reducir la latencia hasta dos veces frente a TPU 8t con un impacto mínimo sobre el rendimiento.
La arquitectura permite además combinar inferencia y trabajos de entrenamiento de menor escala dentro de un mismo entorno. Una organización podría ajustar un modelo con datos privados, destilar un modelo grande para producir una versión más pequeña o entrenar agentes mediante aprendizaje por refuerzo sin trasladar la información a otro clúster.
Esa característica resulta especialmente relevante en sectores como servicios financieros, sanidad, industria o administración pública, donde la localización y el tratamiento de los datos pueden condicionar la arquitectura técnica. El hardware no elimina por sí mismo las obligaciones regulatorias o de gobierno de la información, pero sí incorpora otra capa con la que reducir la exposición de datos y modelos durante su procesamiento.
TPU 8i Max amplía memoria y cómputo para contextos masivos
TPU 8i Max aborda un problema diferente: la presión que las cargas de razonamiento y los agentes ejercen sobre la memoria.
Las ventanas de contexto más grandes permiten que un modelo procese repositorios completos de código, documentos extensos o grandes cantidades de contenido audiovisual, pero también incrementan el volumen de datos que debe mantenerse disponible durante la inferencia. En estas cargas, el rendimiento puede quedar limitado por la capacidad para mover información entre memoria y procesadores antes que por la potencia aritmética del acelerador.
Google ha combinado dos chips TPU 8i de baja latencia dentro de un único encapsulado. El resultado duplica, frente a una TPU 8i, la capacidad de cómputo, la memoria SRAM y el ancho de banda HBM.
La compañía pretende así mantener más información próxima a las unidades de procesamiento y reducir las esperas cuando trabajan sobre contextos extensos. Al colocar el doble de silicio dentro del espacio que ocupa actualmente el sistema en el rack, TPU 8i Max también aumenta la cantidad de capacidad computacional que puede instalarse con una superficie determinada.
La densidad empieza a tener una importancia operativa creciente para proveedores de nube y operadores de centros de datos. La expansión de la IA está elevando las necesidades de energía, refrigeración y espacio físico, por lo que el rendimiento por rack y por vatio se está convirtiendo en una variable tan relevante como las prestaciones máximas de cada acelerador.
Google intenta reducir la dependencia de un ecosistema propio
La expansión del hardware va acompañada de cambios en la capa de software. Durante años, una de las barreras para adoptar TPUs frente a las GPU ha sido la necesidad de trabajar con herramientas y optimizaciones específicas de la plataforma de Google.
En octubre, la compañía publicó como código abierto TorchTPU, su pila nativa para ejecutar PyTorch sobre TPUs, desarrollada conjuntamente con el equipo de PyTorch de Meta. La integración permite utilizar APIs habituales de PyTorch y extiende el soporte a herramientas como Hugging Face, vLLM, SGLang, Ray y TorchTitan.
El cambio tiene una implicación competitiva directa. PyTorch se ha convertido en uno de los entornos predominantes para desarrollar modelos de IA, y facilitar que las mismas cargas puedan trasladarse entre CPU, GPU y TPU reduce el coste técnico de evaluar arquitecturas alternativas.
Google también está ampliando esa estrategia con herramientas para administrar cargas de agentes, distribuir memoria entre distintas capas de la infraestructura y coordinar grandes grupos de TPUs. Entre ellas figura TPU Sync, que combina la memoria HBM de los aceleradores, la DRAM de los hosts, el almacenamiento compartido y la red en una jerarquía común destinada a mover el estado de los modelos según las necesidades de cada carga.
Con TPU 8t, TPU 8i, TPU 8tx y TPU 8i Max, Google está segmentando su infraestructura alrededor de cuatro necesidades distintas: entrenamiento masivo, razonamiento de baja latencia, computación confidencial y procesamiento de contextos de gran tamaño.
Para los responsables de infraestructura, la consecuencia es una oferta de aceleradores cada vez más ligada al perfil concreto de la carga y menos a una única métrica de potencia. La elección de hardware para IA empieza a depender también de dónde residen los datos, cuánta memoria requiere cada modelo, cuánto tiempo permanece inactivo un agente y qué coste supone mover información entre sistemas. Esas variables tendrán un peso creciente a medida que los proyectos de IA pasen de pruebas aisladas a servicios permanentes dentro de las organizaciones.
Sigue el análisis de tecnología empresarial en Google
Añade La Ecuación Digital como fuente preferida y verás más análisis sobre inteligencia artificial, cloud, ciberseguridad, infraestructura de datos y transformación digital en tus resultados de Google.
Seguir La Ecuación Digital en GoogleAl hacer clic podrás seleccionar La Ecuación Digital como fuente preferida en Google.