
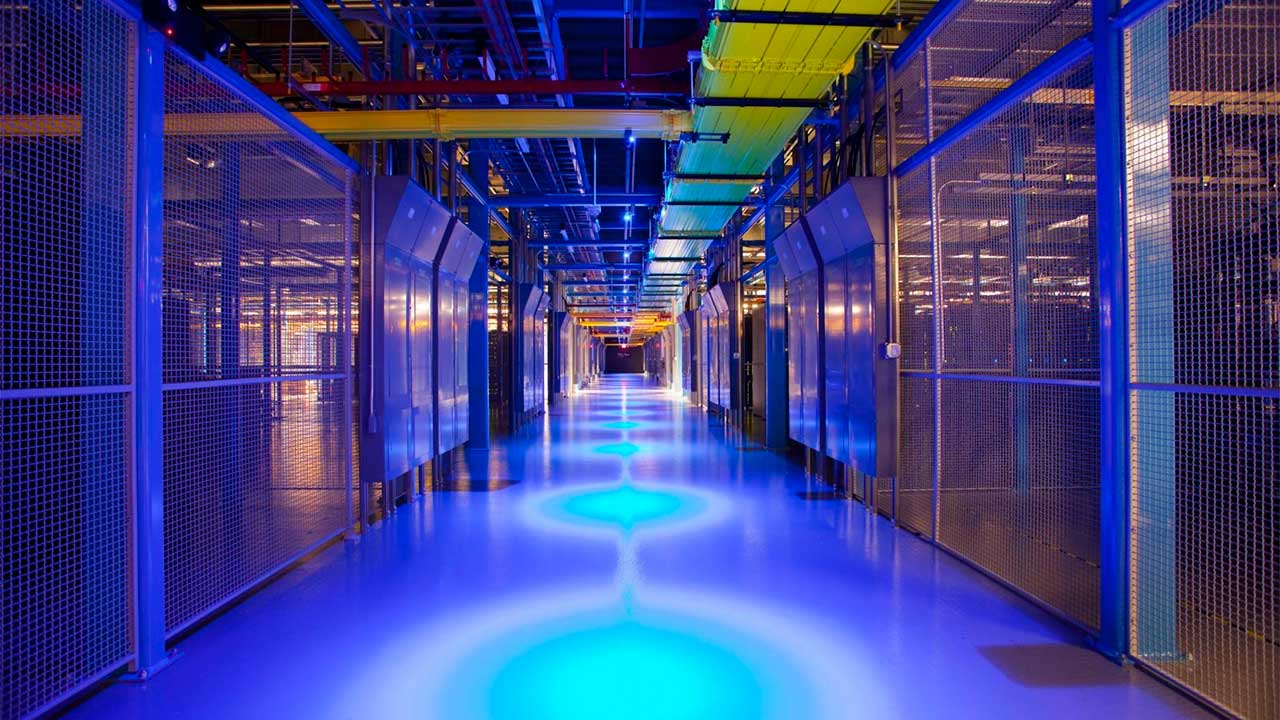

Equinix prepara una infraestructura distribuida para ejecutar modelos de inteligencia artificial más cerca de los datos, las aplicaciones y los usuarios. El futuro servicio, denominado Equinix Inference Exchange, combinará su red de centros de datos e interconexión con las arquitecturas empresariales de NVIDIA y la plataforma de modelos abiertos de Together AI. La propuesta sitúa la ubicación de la inferencia entre las decisiones que condicionan el paso de los proyectos de IA a producción.
La iniciativa amplía la colaboración que Equinix mantiene con NVIDIA e incorpora a Together AI como nuevo socio. Su disponibilidad está prevista para el primer trimestre de 2027, de modo que las empresas aún deberán esperar para conocer cómo se concreta comercialmente el servicio. El planteamiento anticipado permite, sin embargo, observar hacia dónde se desplaza una parte de la competencia en infraestructura de IA: desde la capacidad necesaria para entrenar modelos hacia la operación cotidiana de las consultas que estos reciben.
Este segundo proceso, conocido como inferencia, determina las respuestas que ofrece un modelo una vez entrenado. Ejecutarlo cerca de las fuentes de datos y de quienes utilizan las aplicaciones puede reducir los tiempos de respuesta, mientras que distribuirlo entre diferentes ubicaciones añade decisiones sobre conectividad, capacidad, costes y control. Inference Exchange pretende reunir esas piezas sobre una infraestructura compartida, con acceso a nubes, redes y proveedores de IA mediante Equinix Fabric.
La ubicación de la inferencia entra en la estrategia empresarial
Las organizaciones que avanzan desde las pruebas hacia servicios de IA en producción deben decidir dónde procesan cada carga y cómo la conectan con sus sistemas. La elección afecta a la latencia que percibe el usuario, al coste por token, a la residencia de los datos y al grado de dependencia respecto a un proveedor. También obliga a coordinar entornos que pueden estar repartidos entre centros de datos, nubes y distintas áreas geográficas.
La propuesta de Equinix intenta asumir parte de esa complejidad mediante una capa de distribución apoyada en su infraestructura de interconexión. La compañía sostiene que acercar la ejecución de los modelos a los datos y las aplicaciones reducirá el tiempo hasta el primer token, una métrica vinculada a la rapidez con la que un sistema empieza a responder. El resultado efectivo dependerá de la arquitectura, la ubicación y las cargas desplegadas por cada cliente.
Nick Patience, vicepresidente y responsable de la práctica de plataformas de IA en The Futurum Group, vincula este cambio con una mayor dispersión de la infraestructura: «El rendimiento, los costos y la gobernanza se han convertido en factores estratégicos a medida que las cargas de trabajo de IA se distribuyen más entre distintos proveedores, fuentes de datos y entornos». Esa combinación explica por qué la inferencia empieza a tratarse como una decisión de arquitectura y operación, más allá de la selección del modelo.
Tres capas para desplegar modelos en producción
La distribución de responsabilidades entre los socios delimita el funcionamiento previsto. Equinix aportará los centros de datos, la energía, la refrigeración, el mantenimiento y la conectividad con otros integrantes del ecosistema. NVIDIA proporcionará arquitecturas empresariales de referencia e infraestructura de computación acelerada orientada a mejorar el rendimiento y reducir el coste por token. Together AI operará la plataforma de inferencia y dará acceso a más de 200 modelos de código abierto.
La oferta contemplará dos modalidades de despliegue. Los entornos multitenant permitirán compartir capacidad entre diferentes usuarios, una opción planteada para mejorar la eficiencia. Los entornos dedicados de un solo inquilino reservarán recursos para cargas que requieran capacidad exclusiva. Esta separación puede ser relevante para organizaciones que deban equilibrar utilización, aislamiento y previsibilidad, aunque Equinix todavía no ha detallado precios ni condiciones de contratación con los que comparar ambas alternativas.
El catálogo de Together AI introduce además una vía para utilizar modelos abiertos dentro de la misma infraestructura que conecta a las empresas con otros proveedores. Equinix plantea esta posibilidad para organizaciones que quieran migrar determinadas cargas desde modelos propietarios, controlar costes o reducir la dependencia de una única plataforma. La disponibilidad de más de 200 modelos amplía la elección, pero no elimina el trabajo necesario para evaluar su rendimiento, adaptación y requisitos operativos.
La tecnología de NVIDIA ocupa la capa de computación sobre la que se ejecutarán esos modelos. Las arquitecturas de referencia buscan ofrecer una configuración validada para cargas empresariales y evitar que cada organización tenga que diseñar desde cero todos los componentes. Inference Exchange empleará esa base dentro de instalaciones de Equinix, conectadas a proveedores de inferencia, redes y servicios cloud en distintas áreas metropolitanas.
Del borde metropolitano a la soberanía de los datos
Uno de los casos previstos es la inferencia en el borde metropolitano, destinada a aplicaciones que necesitan operar cerca de usuarios o fuentes de información. Este enfoque puede resultar pertinente cuando el tiempo de respuesta condiciona la experiencia o cuando mover los datos hacia una región lejana resulta poco conveniente. La solución también se dirigirá a despliegues distribuidos entre varias nubes y ubicaciones, con el objetivo de simplificar su conexión.
Otra línea corresponde a las cargas sometidas a requisitos de residencia y soberanía de datos. Equinix prevé permitir que la inferencia se ejecute en ubicaciones ajustadas a esas exigencias, manteniendo el control sobre dónde se procesa la información. La arquitectura distribuida aporta una base para organizar estos despliegues, pero el cumplimiento concreto dependerá de la configuración, la localización elegida y las obligaciones aplicables a cada empresa y sector.
La escala de la red será uno de los activos con los que Equinix intentará sostener el servicio. La empresa atribuye a su plataforma más de 280 centros de datos en 77 áreas metropolitanas, 230 puntos de acceso a la nube y más de 10.500 compañías interconectadas. Estas cifras describen el alcance potencial de la infraestructura, aunque no equivalen a disponibilidad inmediata de Inference Exchange en todas esas instalaciones.
Una capa de conexión para entornos distribuidos
Junto al servicio de inferencia, Equinix presentó Equinix Fabric One, una herramienta concebida para conectar entornos de IA repartidos globalmente. Su función encaja con el mismo problema operativo: una carga puede ejecutarse cerca de determinados datos, depender de servicios alojados en una nube y atender a usuarios desde otra ubicación. La conectividad entre esos puntos pasa así a formar parte del diseño de la aplicación.
Para las empresas, la decisión inmediata será identificar qué cargas justifican una inferencia próxima a los usuarios o a los datos y cuáles pueden permanecer en infraestructuras centralizadas. También deberán comparar modelos abiertos y propietarios, escoger entre capacidad compartida o dedicada y determinar las ubicaciones compatibles con sus obligaciones. Inference Exchange aspira a concentrar esas opciones en una capa común; su utilidad operativa podrá evaluarse cuando el servicio llegue al mercado y se conozcan su cobertura, sus condiciones y sus costes.