
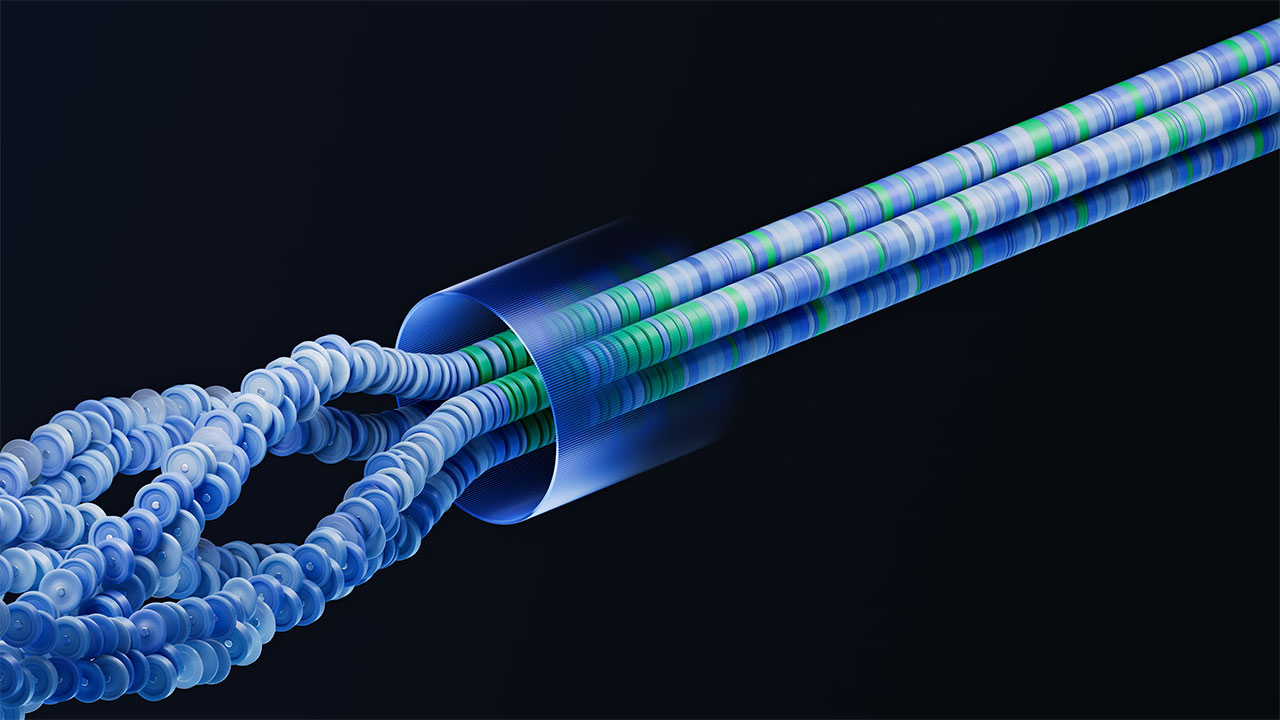

Confluent ha presentado Streamhouse, una arquitectura de datos concebida para mantener actualizado el estado operativo de una organización y ponerlo a disposición de aplicaciones, herramientas analíticas y agentes de inteligencia artificial. La compañía, integrada en IBM, acompaña este planteamiento con nuevas capacidades de consulta que amplían su plataforma de data streaming y reducen la necesidad de trasladar datos a sistemas independientes antes de poder utilizarlos.
La novedad más relevante es la incorporación de Query como quinto pilar de la plataforma de Confluent, junto a Stream, Connect, Process y Govern. El objetivo es cubrir en una misma capa tecnológica la captura de eventos, su movimiento entre sistemas, el procesamiento, la gobernanza y, ahora, la consulta directa de la información resultante.
Dentro de ese nuevo bloque se sitúa Lightning Tables, ya disponible de forma general en AWS. Esta tecnología materializa los datos procedentes de Apache Kafka en tablas de solo lectura que se mantienen actualizadas a medida que se producen cambios. Confluent plantea así una vía para que aplicaciones y agentes consulten el estado actual del negocio sin tener que replicarlo previamente en una base de datos, una caché o una canalización ETL específica.
Una capa operativa sobre los sistemas de datos existentes
El concepto de Streamhouse parte de una limitación habitual en las arquitecturas empresariales: distintos sistemas pueden contener versiones diferentes de una misma realidad operativa porque se actualizan a ritmos distintos.
Los data warehouses, data lakes y lakehouses siguen siendo piezas centrales para almacenamiento, análisis e inteligencia empresarial, pero muchas de sus cargas de trabajo se organizan alrededor de procesos por lotes. Esa separación temporal adquiere más importancia cuando una aplicación automatizada o un agente de IA debe tomar decisiones que afectan directamente a operaciones, clientes o transacciones.
Confluent propone que Streamhouse actúe como una capa adicional que mantenga una representación continuamente actualizada del negocio. La arquitectura no sustituye necesariamente a los repositorios analíticos existentes, sino que pretende cubrir aquellos escenarios en los que la información debe estar disponible mientras se producen los acontecimientos.
El ejemplo planteado por la compañía es el de una aerolínea. La ubicación de un avión, su hora prevista de salida y la disponibilidad de asientos pueden residir en sistemas distintos. Si cada aplicación trabaja con una actualización diferente, un sistema automático de reservas podría ofrecer una conexión técnicamente disponible en el inventario, pero inviable porque la aeronave llegará tarde.
Una arquitectura basada en eventos permite que esos cambios se incorporen de forma continua a una vista compartida. El agente encargado de reasignar al pasajero, el sistema de atención al cliente y las aplicaciones de notificación pueden consultar entonces una información coherente antes de actuar.
Esta diferencia resulta especialmente relevante a medida que las empresas incorporan agentes capaces de ejecutar operaciones y no únicamente de responder consultas. Cuanto mayor es la autonomía del software, mayor es también la necesidad de controlar la vigencia, procedencia y consistencia de los datos utilizados para decidir.
Streamhouse amplía el papel de Kafka
La plataforma de Confluent se apoya en Apache Kafka para capturar y transmitir eventos entre sistemas. Sobre esa base, la compañía ha ido incorporando capas adicionales para reducir el número de componentes que las organizaciones necesitan integrar por separado.
Stream utiliza Kafka y el motor Kora para transportar los eventos. Confluent asegura haber registrado latencias inferiores al milisegundo en pruebas internas, aunque el rendimiento final depende de la configuración y de la carga de trabajo.
Connect proporciona más de 150 conectores gestionados y personalizados para intercambiar información entre Kafka y otros sistemas empresariales. Process emplea Apache Flink para combinar, enriquecer y transformar los datos a medida que cambian, mientras que Govern agrupa funciones de catálogo, trazabilidad, calidad, cifrado, gestión de esquemas y control de acceso.
La incorporación de Query completa ese recorrido desde la captura del evento hasta su consumo por una aplicación. Dentro de este bloque, Confluent diferencia tres mecanismos en función del destino de los datos.
Tableflow convierte los flujos en formatos de tabla abiertos destinados a lakehouses y data warehouses. Real-Time Context Engine proporciona información actualizada a agentes de IA mediante Model Context Protocol (MCP). Lightning Tables cubre la consulta desde aplicaciones mediante SQL, API directa o MCP.
Esta separación refleja un cambio en el uso del streaming. Kafka nació principalmente como una infraestructura para mover eventos entre sistemas, pero las plataformas construidas a su alrededor tratan ahora de cubrir también procesamiento, gobierno y acceso directo a los datos.
Lightning Tables reduce la necesidad de mantener copias adicionales
Lightning Tables constituye la principal ampliación funcional anunciada. La tecnología almacena de forma persistente la información contenida en Kafka y la materializa en tablas que se actualizan conforme llegan nuevos eventos.
De acuerdo con las pruebas internas de Confluent, los nuevos datos pueden estar disponibles para consulta aproximadamente 100 milisegundos después de su creación. La compañía sitúa la latencia de las consultas entre 10 y 100 milisegundos y afirma haber superado las 1.000 consultas por segundo. Son cifras obtenidas en condiciones de prueba propias, por lo que el rendimiento efectivo dependerá del despliegue y del patrón de uso.
La propuesta pretende eliminar parte de la arquitectura que tradicionalmente se interpone entre una plataforma de streaming y las aplicaciones que necesitan leer su contenido. En muchos entornos, los equipos extraen los eventos, los transforman y los copian a una base de datos operacional o a una caché para poder consultarlos con baja latencia.
Lightning Tables concentra esa función dentro de Confluent Cloud. La capa es de solo lectura y mantiene las políticas de esquemas, trazabilidad y acceso aplicadas durante el resto del ciclo de los datos. También incorpora gestión de evolución de esquemas y puede emplearse como almacén de características para modelos de aprendizaje automático, con variables calculadas mediante Flink.
Para los equipos de tecnología, la consecuencia operativa es una posible reducción del número de sistemas que deben desplegar, sincronizar y mantener. El beneficio dependerá, sin embargo, de hasta qué punto las aplicaciones puedan trabajar dentro del modelo de consulta ofrecido por Confluent y de las necesidades de escritura, consistencia o almacenamiento de cada caso.
Los agentes de IA elevan la exigencia sobre la vigencia de los datos
Confluent vincula Streamhouse directamente con el despliegue de IA agéntica. Frente a los sistemas analíticos que toleran cierto retraso entre la generación del dato y su consumo, un agente encargado de cambiar un precio, bloquear una transacción o modificar una reserva necesita conocer el estado de la operación prácticamente en el momento de actuar.
Shaun Clowes, director general de Confluent y Data en IBM, sitúa esa necesidad en el centro de la propuesta: «La próxima era de la IA empresarial estará marcada por aquellos agentes que sepan qué está ocurriendo en el negocio en el mismo momento en que actúan».
La compañía también utiliza como referencia el despliegue realizado en Accenture. Thomas Mahaffey, estratega jefe de datos de SAI en la consultora, sostiene que su arquitectura anterior dependía de procesos por lotes y conexiones punto a punto que generaban duplicidades y retrasaban el acceso a la información. La organización afirma haber reducido «de meses a días» el tiempo necesario para obtener información útil después de adoptar una arquitectura basada en streaming para conectar sistemas operativos y analíticos.
Extend, una plataforma de comercio que emplea Confluent Cloud, utiliza Kafka como referencia para sus operaciones y permite que sus microservicios consuman y consulten información de forma asíncrona. Su director de IA y Arquitectura, Jonathan Kropp, relaciona este modelo con casos de precios en tiempo real, detección de fraude y automatización basada en agentes.
La evolución tiene además una dimensión estratégica para IBM. Tras integrar Confluent en su cartera, el grupo puede combinar el streaming de eventos con sus capacidades de integración, gobernanza e inteligencia artificial para entornos híbridos. Streamhouse encaja así en un mercado en el que proveedores de bases de datos, plataformas analíticas y compañías de streaming compiten por convertirse en la capa de datos utilizada por aplicaciones de IA.
Para las empresas, la decisión arquitectónica no dependerá únicamente de la velocidad. La aparición de sistemas capaces de actuar automáticamente obliga a mantener alineados el acceso en tiempo real, la gobernanza y el control de qué información puede utilizar cada aplicación. La propuesta de Confluent concentra esas funciones alrededor del flujo de eventos y trata de convertir esa capa en un punto común entre operaciones, analítica e inteligencia artificial.
Sigue el análisis de tecnología empresarial en Google
Añade La Ecuación Digital como fuente preferida y verás más análisis sobre inteligencia artificial, cloud, ciberseguridad, infraestructura de datos y transformación digital en tus resultados de Google.
Seguir La Ecuación Digital en GoogleAl hacer clic podrás seleccionar La Ecuación Digital como fuente preferida en Google.