
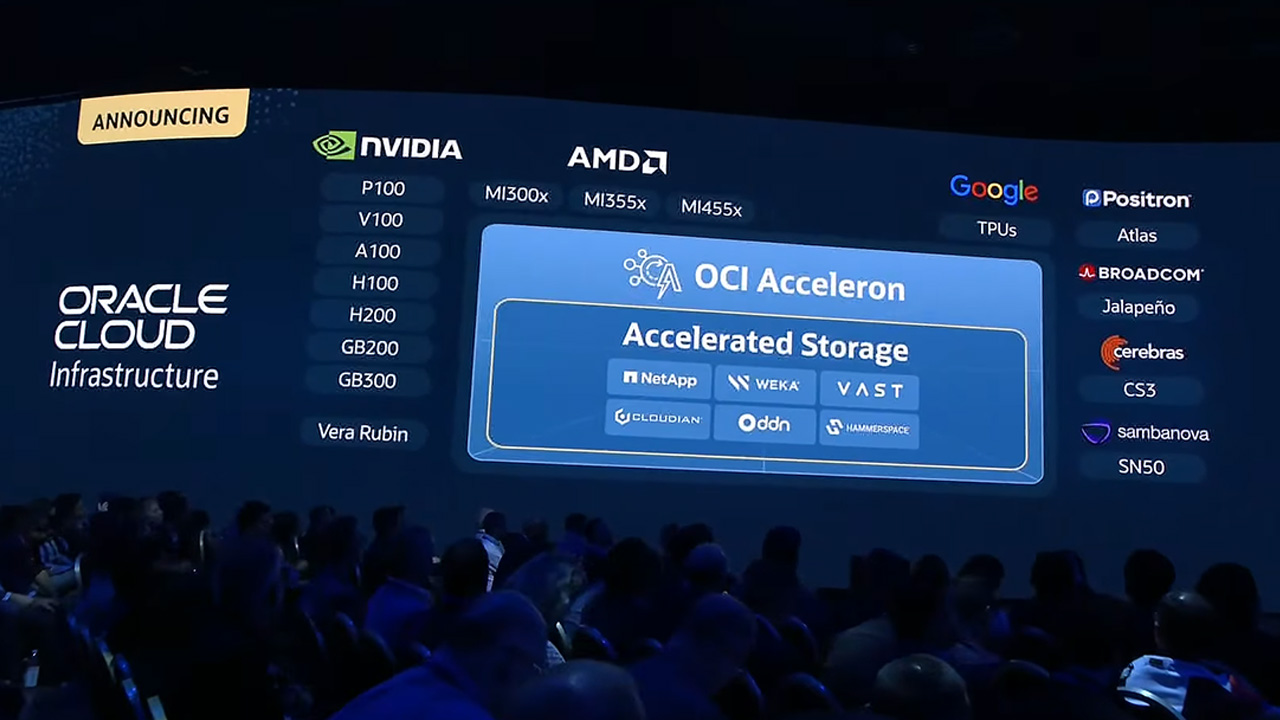

Oracle no está intentando competir con NVIDIA, Google, AMD, Intel o Cerebras en el diseño del próximo chip dominante para inteligencia artificial. Su estrategia con Oracle Cloud Infrastructure (OCI) es situarse una capa por encima de esa competencia: proporcionar el cómputo, la red, el almacenamiento y la infraestructura energética necesarios para ejecutar distintas arquitecturas de IA dentro de una misma plataforma cloud.
Esa posición explica buena parte de los anuncios de infraestructura presentados en Oracle AI World 2026. OCI incorporará las TPU de Google, ampliará sus despliegues con NVIDIA Vera Rubin y sumará sistemas especializados de Cerebras, SambaNova e Intel, mientras adapta Acceleron, su arquitectura de red, y nuevas opciones de almacenamiento para alimentar cargas cada vez más heterogéneas.
El cambio responde a una realidad cada vez más visible en la infraestructura de IA: entrenamiento, inferencia y ejecución de agentes no tienen necesariamente las mismas necesidades de cómputo. Una GPU puede ser adecuada para unas cargas, una TPU para otras y un procesador especializado puede ofrecer ventajas de coste o latencia en determinados escenarios. Oracle quiere que esa elección pueda hacerse en función de cada workload sin obligar al cliente a reconstruir toda la infraestructura que lo rodea.
La compañía está llevando esa lógica también al diseño físico de sus centros de datos. Grandes clústeres de IA dependen tanto de la capacidad de los procesadores como de la velocidad con la que reciben datos, de la resistencia de la red ante congestiones y fallos y de la capacidad eléctrica para soportar variaciones de consumo sincronizadas entre decenas de miles de aceleradores. «Tenemos que pensar en toda la infraestructura de IA como un gran ordenador», explicó Pradeep Vincent, vicepresidente ejecutivo de Compute and AI Infrastructure de OCI, durante la keynote de Clay Magouyrk.
La apuesta de Oracle consiste, por tanto, en hacer que el chip deje de definir por sí solo la arquitectura. Google diseña TPU, NVIDIA desarrolla Vera Rubin y compañías como Cerebras construyen procesadores orientados a cargas concretas. OCI quiere proporcionar la capa común sobre la que puedan operar todas ellas.
Google rompe la exclusividad de sus TPU fuera de su propia nube
El movimiento más significativo por lo que implica para el mercado cloud es el acuerdo con Google.
OCI será el primer hyperscaler fuera de Google que ofrecerá sus Tensor Processing Units. Oracle prevé comenzar en 2027 con la octava generación de TPU y ampliar la capacidad durante los años siguientes hasta escala de gigavatios.
Las TPU fueron diseñadas específicamente por Google para cargas de machine learning y hasta ahora su disponibilidad cloud estaba asociada a Google Cloud. Llevarlas a OCI abre una segunda vía de consumo y proporciona a Oracle una arquitectura alternativa a las GPU en entrenamiento e inferencia de gran escala.
La octava generación se divide además en dos diseños diferentes. TPU 8t está orientada a entrenamiento, mientras TPU 8i está optimizada para inferencia. Google sostiene que 8t proporciona cerca de tres veces más capacidad de cómputo por pod que la generación anterior y que 8i está diseñada, entre otros escenarios, para cargas iterativas generadas por múltiples agentes.
«Las diferentes cargas de IA tienen distintas necesidades de cómputo», resume Mahesh Thiagarajan, presidente de OCI. «Llevar Google TPU a OCI proporciona a los clientes acceso a múltiples arquitecturas líderes de cómputo de IA en una misma nube.»
La decisión permite entender mejor hacia dónde quiere llevar Oracle su infraestructura. La empresa no está intentando sustituir NVIDIA ni apostar por una arquitectura ganadora. Busca que entrenamiento, post-training, inferencia, razonamiento agéntico y aplicaciones empresariales puedan asignarse a diferentes combinaciones de hardware en función de rendimiento, throughput, consumo y coste.
Para Google también es un cambio relevante: sus aceleradores pasan a formar parte de una nube competidora. Para Oracle supone incorporar una tecnología diferenciada sin asumir el coste y el tiempo necesarios para desarrollar una familia propia equivalente.
NVIDIA sigue ocupando la escala más alta de OCI
Diversificar no significa reducir el papel de NVIDIA.
Oracle y NVIDIA han ampliado sus planes para desplegar Vera Rubin NVL72 en OCI a escala de varios gigavatios. Tanto estos sistemas como las CPU NVIDIA Vera están ya disponibles de forma general, mientras Oracle prepara también configuraciones HGX Rubin NVL8.
Los Superclusters de OCI combinan racks NVL72, la red Oracle Acceleron y NVIDIA Spectrum-X con infraestructura de potencia y refrigeración diseñada para despliegues de escala gigavatio. Cada rack conecta 72 GPU mediante NVLink y la red multiplano de OCI permite extender el sistema a cientos de miles de aceleradores.
Esa escala está orientada principalmente a laboratorios y compañías que entrenan o sirven modelos de frontera. Oracle señala como referencia el Supercluster de Abilene utilizado por OpenAI, con más de 100.000 GPU NVIDIA Blackwell.
Hay, sin embargo, otra parte del anuncio que explica por qué Oracle está separando cada vez más los distintos tipos de cómputo dentro de una carga de IA: Vera CPU.
Un agente no pasa todo su tiempo ejecutando inferencia sobre una GPU. Entre una llamada al modelo y la siguiente tiene que recuperar información, ejecutar código, utilizar herramientas, procesar datos o interactuar con aplicaciones. Buena parte de esas operaciones son intensivas en CPU.
OCI permitirá escalar CPU y GPU de forma independiente, de manera que una organización no tenga que mantener aceleradores costosos esperando mientras se realizan tareas que pueden ejecutarse mejor sobre CPU. Oracle afirma haber iniciado un despliegue de 150.000 Vera CPU destinado a este tipo de cargas agénticas.
Esta separación tiene una consecuencia económica importante. A medida que los agentes ejecuten procesos más largos, el coste de la infraestructura dependerá menos de una métrica aislada de GPU y más del equilibrio entre inferencia, CPU, memoria, red y almacenamiento.
Cerebras entra por la velocidad de inferencia
Cerebras ocupa otro extremo de esa estrategia.
Oracle prevé ofrecer en OCI durante 2027 la tecnología de inferencia de Cerebras basada en Wafer-Scale Engine, una arquitectura que integra cómputo y memoria sobre un procesador a escala de oblea. Su objetivo es reducir el movimiento de datos y la comunicación entre chips, dos factores que pueden añadir latencia durante secuencias largas de inferencia.
La velocidad adquiere una importancia diferente con agentes.
Una respuesta convencional puede depender de una llamada principal a un modelo. Un agente que investiga, razona, consulta herramientas, comprueba el resultado y vuelve a actuar puede realizar numerosas inferencias antes de completar una tarea. La latencia de cada una se acumula.
«Cada paso que da un agente requiere inferencia, ya sea para razonar, comprobar su trabajo o actuar», explica Andrew Feldman, cofundador y CEO de Cerebras.
Mahesh Thiagarajan resume la lógica de Oracle de una forma todavía más clara: «La inferencia de IA exige elección».
OCI está incorporando por esa misma razón sistemas SN50 de SambaNova y ya trabaja con Positron para determinadas cargas de inferencia. Durante su keynote, Clay Magouyrk añadió a esa lista Jalapeño, el chip desarrollado por OpenAI y Broadcom alrededor de los modelos de OpenAI.
La combinación muestra una infraestructura cada vez más segmentada. Las arquitecturas que compiten por entrenamiento de modelos de frontera no tienen necesariamente que ser las mismas que optimizan inferencia de baja latencia o procesos agénticos de gran volumen.
Intel y AMD mantienen el peso de la CPU empresarial
Oracle e Intel preparan una colaboración plurianual que incluye futuras instancias OCI X14 basadas en los procesadores Diamond Rapids. El acuerdo pone un énfasis especial en aplicaciones empresariales, inferencia y ejecución agéntica.
Es un recordatorio de que la extensión de IA sobre sistemas empresariales existentes genera una clase de carga distinta a entrenar un gran modelo. Un agente puede consumir una GPU o TPU para razonamiento y, segundos después, depender de CPU para ejecutar una aplicación, mover información, aplicar reglas o consultar una base de datos.
Intel prevé incorporar en Diamond Rapids extensiones AMX con formatos FP8, FP16 y BF16 para inferencia, junto con mejoras destinadas al cómputo general. La intención de OCI es permitir que esas tareas escalen independientemente de los aceleradores utilizados por los modelos.
AMD mantiene igualmente una posición dentro de esa arquitectura. Las futuras instancias OCI Compute E7 utilizarán procesadores EPYC de sexta generación, mientras los DPU AMD Pensando soportarán NIC de Oracle Acceleron en las configuraciones basadas en AMD.
La fotografía resultante se aleja de la visión simplificada en la que infraestructura de IA equivale únicamente a disponer de GPU. La GPU continúa siendo crítica para muchas cargas, pero el sistema que la rodea determina cada vez más cuánto rendimiento efectivo puede obtenerse de ella.
Un segundo de red puede convertirse en 28 horas de GPU
Oracle introdujo la arquitectura Acceleron en 2025 para conectar grandes clústeres de IA mediante fabrics dedicadas, NIC convergentes, múltiples rutas y controles de seguridad integrados en la infraestructura.
La nueva generación extiende las redes multiplano que OCI utiliza en el backend hacia el frontend e incorpora conectividad RDMA para cargas de inferencia, almacenamiento y HPC. También amplía las opciones de conexión NVMe y añade Oracle Collective Communications Library para dirigir tráfico distribuido hacia rutas que se mantienen operativas cuando aparecen fallos o congestión.
La necesidad de esta arquitectura se entiende mejor con el ejemplo que dio Pradeep Vincent durante la keynote.
En un clúster de entrenamiento con 100.000 GPU, explicó, si una sola queda bloqueada durante un segundo esperando un paquete de red, el conjunto puede acumular unas 28 horas-GPU de retraso. El motivo es que el entrenamiento distribuido sincroniza trabajo entre numerosos aceleradores y una unidad retrasada puede detener temporalmente a las demás.
«Es un atasco realmente grande», resumió Vincent.
Acceleron intenta reducir ese riesgo conectando las GPU a varias redes independientes. Cuando una ruta presenta problemas, el tráfico puede trasladarse a otro plano en lugar de depender únicamente de enlaces redundantes dentro de la misma red.
«Ya no tenemos solamente enlaces redundantes, tenemos redes redundantes», explicó Vincent.
La diferencia importa porque un acelerador que espera datos continúa representando capital invertido pero deja de producir trabajo útil. Con GPU y sistemas rack-scale que concentran una parte creciente del coste de un centro de datos de IA, Oracle está tratando la red como un componente directamente relacionado con la rentabilidad de la infraestructura.
RDMA lleva el almacenamiento al mismo problema de rendimiento
La extensión de Acceleron al frontend permite además utilizar RDMA, una tecnología que facilita transferencias directas de memoria entre sistemas con menor intervención del procesador y menor latencia.
Eso conecta la evolución de la red con otra pieza que puede limitar grandes cargas de IA: el almacenamiento.
OCI prepara OCI NetApp Storage Service, un servicio gestionado basado en las capacidades de ONTAP, y ha creado un programa para conectar almacenamiento acelerado de proveedores como Weka, VAST y DDN con Acceleron.
La intención es que diferentes aceleradores puedan acceder a esos sistemas mediante RDMA sin construir una arquitectura de almacenamiento independiente para cada plataforma de cómputo.
Oracle está intentando resolver así una consecuencia de su propia estrategia multiacelerador. Ofrecer TPU, GPU y procesadores especializados aporta flexibilidad, pero puede multiplicar la complejidad si cada arquitectura necesita redes, almacenamiento y procedimientos operativos diferentes.
Acceleron funciona como la capa destinada a reducir esa fragmentación.
«Una infraestructura de IA puede ser implacable con la fricción de red», explica Vincent. «Cuando miles de aceleradores trabajan juntos, una ruta congestionada o averiada puede tener consecuencias mucho mayores que las de una única conexión.»
La energía se convierte en parte de la arquitectura informática
Oracle dispone de regiones dedicadas que pueden ocupar apenas tres racks, pero sus mayores regiones de IA se extienden ya por campus de miles de acres. Magouyrk explicó que la IA está cambiando tanto el lugar donde Oracle construye estos centros como su diseño físico.
La electricidad plantea un problema que no se limita a consumir más megavatios.
Una carga informática tradicional agrega numerosos sistemas cuyos cambios de consumo no están perfectamente sincronizados. Un gran entrenamiento de IA puede coordinar decenas de miles de aceleradores que elevan o reducen su demanda prácticamente al mismo tiempo.
Vincent utilizó una comparación sencilla: un calefactor doméstico de 1 kW no preocupa a la red eléctrica. Un millón de calefactores conectándose y desconectándose exactamente en el mismo milisegundo sí lo harían.
Eso se aproxima al comportamiento de un gran clúster de IA.
Oracle está utilizando sistemas de almacenamiento energético, baterías y en algunos casos supercondensadores, junto con electrónica de potencia, para suavizar esos cambios. Cuando el clúster aumenta rápidamente la carga, parte de la energía procede temporalmente del almacenamiento. Cuando reduce el consumo, ese mismo sistema absorbe energía y vuelve a cargarse. De esta forma, la red eléctrica percibe una variación más progresiva.
Magouyrk lo describió como el equivalente eléctrico de «un gigantesco amortiguador».
Este problema ayuda a explicar por qué las cifras de gigavatios han empezado a aparecer en los anuncios de infraestructura de IA. A partir de cierto tamaño, construir capacidad ya no consiste únicamente en instalar servidores disponibles comercialmente. Requiere coordinar generación y acceso eléctrico, refrigeración, acondicionamiento de potencia, networking y diseño del propio campus.
OCI intenta diferenciarse por elección y no por una arquitectura propietaria única
Los anuncios de Oracle AI World muestran una decisión estratégica bastante definida.
Google controla TPU. NVIDIA desarrolla Vera Rubin y Vera. AMD e Intel mantienen sus propias hojas de ruta. Cerebras y SambaNova introducen arquitecturas diferentes para inferencia. OpenAI y Broadcom trabajan en silicio adaptado a modelos concretos.
Oracle está intentando situarse un nivel por encima de esa competencia: proporcionar el centro de datos, la red, el almacenamiento, la energía y la operación que permitan consumir varias de esas arquitecturas desde OCI.
Eso presenta una ventaja potencial para clientes que todavía no saben qué combinación de hardware dominará sus cargas durante los próximos años. La rápida evolución de modelos puede dejar capacidad especializada peor adaptada a nuevos workloads. Mantener distintas opciones dentro de la misma infraestructura permite reasignar cargas sin trasladar necesariamente todo el entorno a otro proveedor cloud.
También introduce nuevas complejidades. Las diferencias de software, disponibilidad regional, precios y optimización entre GPU, TPU y procesadores especializados no desaparecen porque compartan proveedor cloud. Parte de las capacidades anunciadas, además, siguen siendo planes futuros: Google TPU y Cerebras están previstas para 2027, la colaboración con Intel y sus instancias X14 está todavía planteada como hoja de ruta y la expansión de Vera Rubin a varios gigavatios se ejecutará progresivamente.
Oracle tendrá que demostrar que la diversidad de hardware se traduce realmente en flexibilidad operacional y económica para el cliente y no simplemente en un número mayor de configuraciones.
La arquitectura que está construyendo alrededor de Acceleron apunta precisamente a ese problema. Si red, almacenamiento y seguridad pueden mantenerse relativamente constantes mientras cambia el tipo de acelerador, la elección del chip puede convertirse en una decisión asociada al workload en lugar de determinar toda la arquitectura del centro de datos.
La frase de Vincent durante la keynote resume mejor esta transición que cualquier listado de procesadores: «Tenemos que pensar en toda la infraestructura de IA como un gran ordenador».
En ese ordenador, las GPU siguen siendo una pieza fundamental, pero ya no explican por sí solas el sistema. La capacidad de OCI para competir en la siguiente fase de infraestructura de IA dependerá de cuánto rendimiento consiga extraer de una combinación mucho más heterogénea de aceleradores, CPU, red, almacenamiento y energía, y de si esa heterogeneidad permite a sus clientes mejorar la economía de cada entrenamiento, cada inferencia y cada proceso ejecutado por agentes.